Git 基础概念与操作速览
从版本控制基础到企业级实践的完整 Git 知识体系,覆盖原理、操作、工作流三大维度。
目录结构
| 章节 | 内容 | 篇数 |
|---|---|---|
| 01-基础概念 | VCS 概念、分布式版本控制、Git 操作速览 | 3 |
| 02-对象模型与原理 | 对象模型、仓库目录结构、索引、存储与压缩 | 4 |
| 03-安装配置与仓库 | 安装配置、创建与克隆仓库、工作区暂存区、gitignore | 4 |
| 04-分支与合并 | 分支操作、merge/rebase、checkout/reset 的本质 | 6 |
| 05-撤销与恢复 | 撤销提交、丢弃提交、reflog、stash | 6 |
| 06-查看与调试 | 历史与差异、bisect 调试、冲突解决实战 | 3 |
学习路径
图表渲染中…
版本控制系统
版本控制系统 VCS
版本控制系统(VCS)最基本的功能是版本控制。所谓版本控制,意思就是在文件的修改历程中保留修改历史,让你可以方便地撤销之前对文件的修改操作
最简化的版本控制模型,是大多数主流文本编辑器都有的
撤销 Undo功能。
VCS 保存修改历史,使用的是主动提交改动的机制。在修改了代码之后,使用 commit 命令把改动和对改动的描述信息提交,这次改动就被记录到版本历史中了。如果希望回退到这个版本,就可以从 VCS 的历史日志中方便地找到它
中央仓库
更多的时候会是多个人共同开发,就需要有中央仓库作为代码的存储中心。所有人的改动都会上传到这里,所有人都能也都能看到和下载到别人上传的改动
版本控制、主动提交、中央仓库 这三个要素,共同构成了版本控制系统(VCS)的核心。开发团队中的每个人向中央仓库主动提交自己的改动和同步别人的改动,并在需要的时候查看和操作历史版本,这就是版本控制系统。
中央式版本控制系统
最初的版本控制系统,是中央式版本控制系统 Centralized VCS。假设在一个三人团队,决定使用中央式 VCS 来管理代码:
- 作为项目的主工程师,你独自一人花两天时间搭建了项目的框架;
- 然后在公司的服务器上创建了一个中央仓库,并把你的代码提交到了中央仓库上;
- 两个队友从中央仓库取到初始代码,从此刻开始,你们三人开始并行开发;
- 在之后的开发过程中,每人独立负责开发一个功能,在这个功能开发完成后,这个人就把他的这些新代码提交到中央仓库;
- 每次当有人把代码提交到中央仓库的时候,另外两个人就可以选择把这些代码同步到自己的机器上,保持自己的本地代码总是最新的
而对于团队中的每个人来说,就会更简单一点:
- 第一次加入团队时,把中央仓库的代码取下来;
- 写完的新功能提交到中央仓库;
- 同事提交到中央仓库的新代码,及时同步下来。
这就是中央式 VCS 最基本的工作模型,但实际的开发时常会需要处理代码冲突、查看版本历史、回退代码版本等
分布式版本控制系统
分布式版本控制系统(Distributed VCS / DVCS)和中央式的区别在于,分布式 VCS 除了中央仓库之外,还有本地仓库:团队中每一个成员的机器上都有一份本地仓库,这个仓库里包含了所有的版本历史,或者换句话说,每个人在自己的机器上就可以提交代码、查看历史,而无需联网和中央仓库交互——当然,取而代之的,你需要和本地仓库交互。
中央式 VCS 的中央仓库有两个主要功能:保存版本历史、同步团队代码。而在分布式 VCS 中,保存版本历史的工作转交到了每个团队成员的本地仓库中,中央仓库就只剩下了同步团队代码这一个主要任务。它的中央仓库依然也保存了历史版本,但这份历史版本更多的是作为团队间的同步中转站。
工作模型
依然以三人团队为例,分布式 VCS 的工作模型大致是这样:
- 首先 作为主工程师,独立搭建了项目架构,并把这些代码提交到了本地仓库;
- 然后在服务器上创建了一个中央仓库,并把 1 中的提交从本地仓库推送到了服务器的中央仓库;
- 其他同事把中央仓库的所有内容克隆到本地,拥有了各自的本地仓库,从此刻开始,你们三人开始并行开发;
- 三人总是每人独立负责开发一个功能,在这个功能开发过程中,一个人会把它的每一步改动提交到本地仓库
- 在一个人把某个功能开发完成之后,他就可以把这个功能相关的所有提交从本地仓库推送到中央仓库;
- 每次当有人把新的提交推送到中央仓库的时候,另外两个人就可以选择把这些提交同步到自己的机器上,并把它们和自己的本地代码合并
优缺点
分布式 VCS 的优点:
- 大多数的操作可以在本地进行,所以速度更快,而且由于无需联网,所以即使不在公司甚至没有在联网,你也可以提交代码、查看历史,从而极大地减小了开发者的网络条件和物理位置的限制(例如可以在飞机上提交代码、切换分支等等)
- 由于可以提交到本地,所以可以分步提交代码,把代码提交做得更细,而不是一个提交包含很多代码,难以 review 也难以回溯
分布式 VCS 的缺点:
- 由于每一个机器都有完整的本地仓库,所以初次
clone的时候会比较耗时; - 由于每个机器都有完整的本地仓库,所以本地占用的存储比中央式 VCS 要高。
对于一般的程序项目而言,由于项目的大多数内容都是文本形式的代码,所以工程的体积都并不是很大,再加上文本内容自身的特点,VCS 可以利用算法来把仓库的体积极大地压缩。这就导致,在实际中,Git 等分布式 VCS 的仓库体积并不大,初次获取项目的耗时和本地仓库的存储占用都很小。所以对于大多数的程序项目而言,分布式 VCS 「尺寸大、初次下载慢」的问题其实并不严重。
不过也有一些例外,比如游戏开发。游戏的开发中有大量的大尺寸数据和媒体文件,并且这些文件的格式也不容易压缩尺寸,如果用分布式 VCS 会导致仓库的体积非常庞大。所以一些大型游戏的开发会选择中央式的 VCS 来管理代码
git 快速上手
git 官网 安装 git
在 GitHub 上建一个自己的练习项目(下文以 your-name/learn-git 为例)。 .git 目录就是 本地仓库, .git 所在的这个根目录,称为 Git 的工作目录,它保存当前从仓库中签出(checkout)的内容
bash
# 获取远程仓库
git clone https://github.com/your-name/learn-git.git

git log

# 创建 index.txt 文件
touch index.txt

git status

git add index.txt

git commit -a -m "新建 index.txt 文件"

vim index.txt

git add index.txt

git commit -a -m "修改 index.txt 文件"

git log

git push
merge 合并 commits
merge 含义
merge 的意思是合并,指定一个 commit,把它合并到当前的 commit 来。具体来讲,merge 做的事是:
从目标 commit 和当前 commit (即 HEAD 所指向的 commit)分叉的位置起,把目标 commit 的路径上的所有 commit 的内容一并应用到当前 commit,然后自动生成一个新的 commit
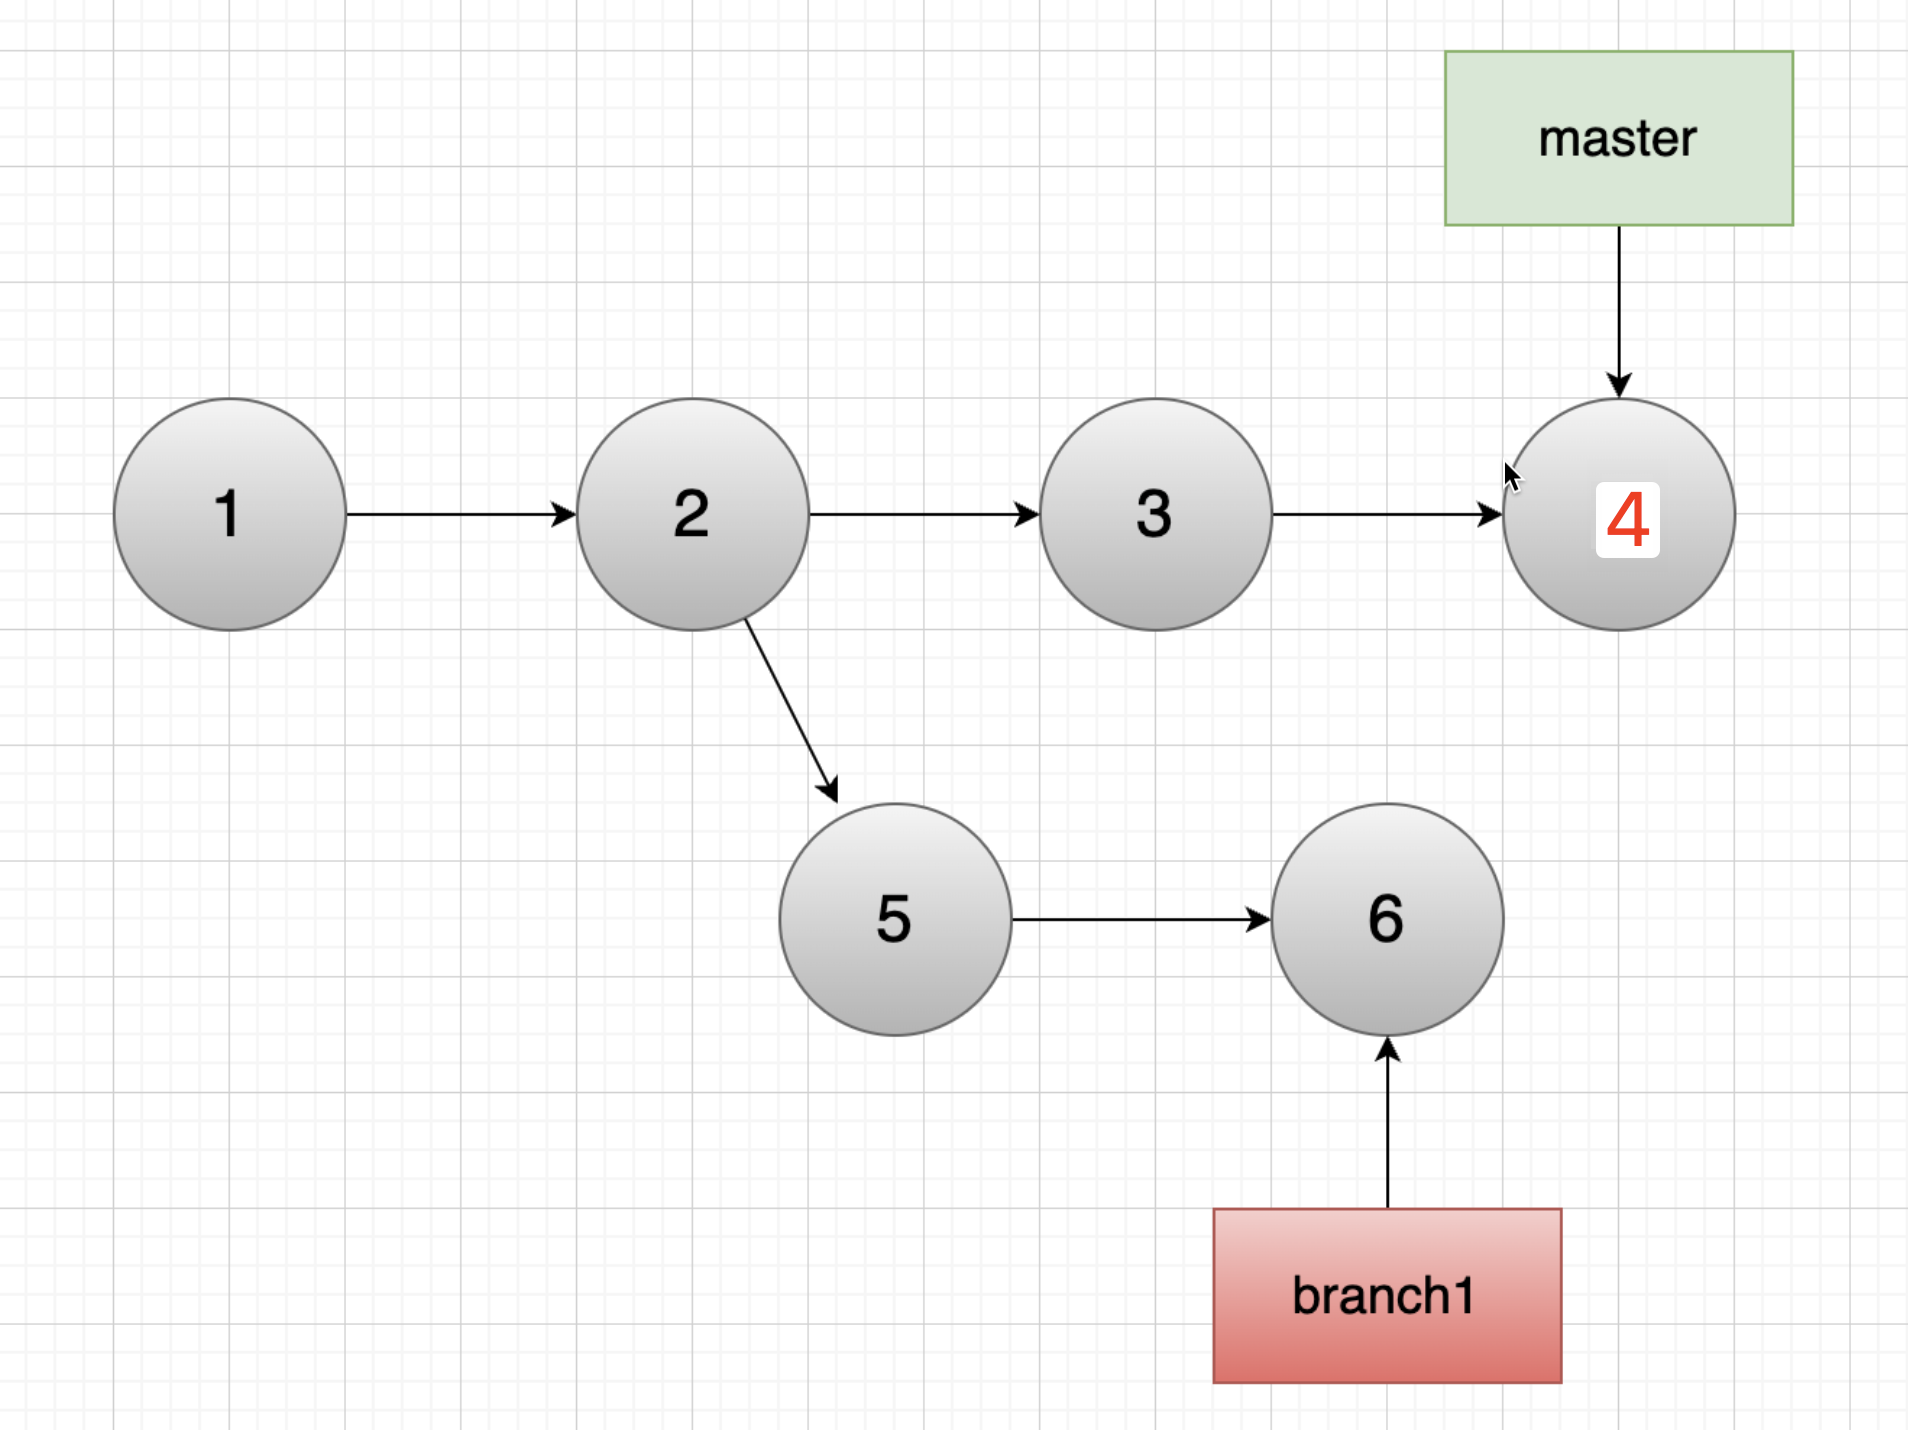
HEAD 指向 master,Git 会把 5 和 6 这两个 commit 的内容一并应用到 4 上,然后生成一个新的提交,并跳转到提交信息填写的界面
bash
git merge branch1merge 操作会帮你自动地填写简要的提交信息。在提交信息修改完成后,就可以退出这个界面,然后这次 merge 就算完成
适用场景
merge 最常用的场景有两处:
-
合并分支,当一个
branch的开发已经完成,需要把内容合并回去时,用merge来进行合并 -
pull的内部操作,pull的实际操作其实是把远端仓库的内容用fetch取下来之后,用merge来合并
特殊情况-冲突
merge 在做合并的时候,是有一定的自动合并能力的。
如果一个分支改了 A 文件,另一个分支改了 B 文件,那么合并后就是既改 A 也改 B,这个动作会自动完成;如果两个分支都改了同一个文件,但一个改的是第 1 行,另一个改的是第 2 行,那么合并后就是第 1 行和第 2 行都改,也是自动完成
但两个分支修改了同一部分内容,merge 的自动算法就搞不定了。这种情况称之为:冲突。如果在 merge 的时候发生了这种情况,Git 就会把问题交给你来决定。具体地,它会告诉你 merge 失败,以及失败的原因:
shell
git merge feature1解决冲突
那么现在需要做两件事:
- 解决掉冲突。Git 虽然没有帮完成自动
merge,但它对文件还是做了一些工作:它把两个分支冲突的内容放在了一起,并用符号标记出了它们的边界以及它们的出处 - 手动
commit一下
shell
git add .
git commit -a -m "解决冲突"
被冲突中断的 merge,在手动 commit 的时候依然会自动填写提交信息。这是因为在发生冲突后,Git 仓库处于一个「merge 冲突待解决」的中间状态,在这种状态下 commit,Git 就会自动地帮你添加「这是一个 merge commit」的提交信息
放弃解决冲突
由于现在 Git 仓库处于冲突待解决的中间状态,最终决定放弃这次 merge,需要执行一次 git merge --abort 来手动取消它。输入这行代码,你的 Git 仓库就会回到 merge 前的状态
shell
git merge --abort特殊情况-HEAD 领先于目标 commit
如果 merge 时的目标 commit 和 HEAD 处的 commit 并不存在分叉,而是 HEAD 领先于目标 commit。
这里指的是目标
commit已经包含在HEAD的历史中
那么 merge 就没必要再创建一个新的 commit 来进行合并操作。在这种情况下,Git 什么也不会做,merge 是一个空操作
特殊情况-HEAD 落后于目标 commit
如果 HEAD 和目标 commit 依然是不存在分叉,但 HEAD 不是领先于目标 commit,而是落后于目标 commit。那么 Git 会直接把 HEAD(以及它所指向的 branch,如果有的话)移动到目标 commit:
shell
git merge feature1这种操作有一个专有称谓,叫做 "fast-forward"(快速前移)
一般情况下,创建新的 branch 都是会和原 branch (例如上图中的 master )并行开发的,不然没必要开 branch ,直接在原 branch 上开发就好。但事实上,上图中的情形其实很常见,因为这其实是 pull 操作的一种经典情形:本地的 master 没有新提交,而远端仓库中有同事提交了新内容到 master。
那么这时如果在本地执行一次 pull 操作,就会由于 HEAD 落后于目标 commit (也就是远端的 master)而造成 "fast-forward":
shell
git pull而 git pull 的第二步操作 merge 的目标 commit,是当前分支对应的远端跟踪分支(例如在 master 上就是 origin/master),所以 git pull 的第二步的完整内容是:
shell
git merge origin/master因此 HEAD 就会带着 master 一起,指向最新的 commit
add 操作
通过 add 来把改动的内容放进暂存区
add 指令除了 git add 文件名 之外,还可以使用 add . 来直接把工作目录下的所有改动全部放进暂存区:
bash
git status

git add .
git status
add 添加的是文件改动,而不是文件名
假如修改文件 a.txt,然后把它 add 进了暂存区:
shell
git add a.txt
git status
然后又往 a.txt 里写了几行东西。这时候再 status 一下的话:
shell
git status会发现 a.txt 既在 "Changes to be committed" 的暂存区,又在 "Changes not staged for commit"。这是因为通过 add 添加进暂存区的不是文件名,而是具体的文件改动内容。你在 add 时的改动都被添加进了暂存区,但在 add 之后的新改动并不会自动被添加进暂存区。
在这时如果你提交,那些新的改动是不会被提交的
shell
git commit查看操作
log 操作
执行 git log 可以查看历史记录:
shell
git loglog -p 查看详细历史
-p 是 --patch 的缩写,通过 -p 参数查看具体每个 commit 的改动细节,很适合用于代码 review
shell
git log -plog --stat 查看简要统计
如果只想大致看一下改动内容,但并不想深入每一行的细节(例如回顾一下自己是在哪个 commit 中修改了 games.txt 文件),那么可以把选项换成 --stat
shell
git log --statshow 查看具体 commit
如果想看某个具体的 commit 的改动内容,可以用 show。直接输入就是查看当前 commit 改动内容
shell
git show在 show 后面加上这个 commit 的引用(branch 或 HEAD 标记)或它的 SHA-1 码:
shell
git show 5e68b0d8查看看指定 commit 中的指定文件,在 commit 的引用后输入文件名:
shell
git show 5e68b0d8 index.txtdiff 查看未提交的内容
如果想看未提交的内容,可以用 diff
使用 git diff --staged 可以显示暂存区和上一条提交之间的不同。换句话说,这条指令可以让你看到「如果你立即输入 git commit,你将会提交什么」:
shell
git diff --staged--staged 有一个等价的选项叫做 --cached。这里所谓的「等价」,是真真正正的等价,它们的意思完全相同
比对工作目录和暂存区
使用 git diff (不加选项参数)可以显示工作目录和暂存区之间的不同。使用这条指令可以让你看到「如果现在把所有文件都 add,你会向暂存区中增加哪些内容」:
shell
git diff比对工作目录和上一条提交
使用 git diff HEAD 可以显示工作目录和上一条提交之间的不同,它是上面这二者的内容相加。使用这条指令可以让你看到「如果你现在把所有文件都 add 然后 git commit,你将会提交什么」(不过需要注意,没有被 Git 记录在案的文件——即从来没有被 add 过的 untracked files——并不会显示出来,因为对 Git 来说它并不存在)
shell
git diff HEAD实质上如果把 HEAD 换成别的 commit,也可以显示当前工作目录和这条 commit 的区别
rebase 操作
在 merge 之后,commit 历史就会出现分叉,这种分叉再汇合的结构会让有些人觉得混乱而难以管理。如果不希望 commit 历史出现分叉,可以用 rebase 来代替 merge
bash
git rebase 目标基础点rebase——在新位置重新提交
rebase 的意思是,把你的 commit 序列重新设置基础点(也就是父 commit)。展开来说就是,把指定的 commit 以及它所在的 commit 串,以指定的目标 commit 为基础,依次重新提交一次。例如下面这个 merge:
bash
git merge branch1如果把 merge 换成 rebase,可以这样操作:
shell
git checkout branch1
git rebase master
可以看出通过 rebase,5 和 6 两条 commit 把基础点从 2 换成了 4 。通过这样的方式,就让本来分叉了的提交历史重新回到了一条线。这种「重新设置基础点」的操作,就是 rebase 的含义
另外在 rebase 之后,记得切回 master 再 merge 一下,把 master 移到最新的 commit:
bash
git checkout master
git merge branch1
为什么要从 branch1 来 rebase,然后再切回 master 再 merge 一下这么麻烦,而不是直接在 master 上执行 rebase?
从图中可以看出,
<img src="https://zhangzhengyang.oss-cn-beijing.aliyuncs.com/images/202410132325395.png" alt="image-20241013232536222" style="zoom:50%;" />rebase后的commit虽然内容和rebase之前相同,但它们已经是不同的commits了。如果直接从master执行rebase的话,就会是下面这样:这就导致
master上之前的两个最新commit被剔除了。如果这两个commit之前已经在中央仓库存在,这就会导致没法push。所以,为了避免和远端仓库发生冲突,一般不要从master向其他branch执行rebase操作。而如果是master以外的branch之间的rebase(比如branch1和branch2之间),就不必这么多费一步,直接rebase就好
reset 本质
在最新的 commit 写错时,可以用 reset --hard 来把 commit 撤销:
bash
git reset --hard HEAD^reset 的本质:移动 HEAD 以及它所指向的 branch
reset 实质是移动 HEAD ,并且带上 HEAD 所指向的 branch(如果有的话)。也就是说,reset 这个指令的行为其实和它的字面意思 "reset" 十分相符:它是用来重置 HEAD 以及它所指向的 branch 的位置的。
而 reset --hard HEAD^ 之所以起到了撤销 commit 的效果,是因为它把 HEAD 和它所指向的 branch 一起移动到了当前 commit 的父 commit 上,从而起到了「撤销」的效果。
Git 的历史只能往回看,不能向未来看,所以把
HEAD和branch往回移动,就能起到撤回commit的效果
所以同理,reset --hard 不仅可以撤销提交,还可以用来把 HEAD 和 branch 移动到其他的任何地方。
bash
git reset --hard branch2reset --hard:重置工作目录和暂存区
reset --hard 会在重置 HEAD 和 branch 的同时,重置工作目录里的内容。当在 reset 后面加了 --hard 参数时,你的工作目录里的内容会被完全重置为和 HEAD 的新位置相同的内容。换句话说,就是你的未提交的修改会被全部擦掉
例如在上次 commit 之后又对文件做了一些改动,然后执行 reset 并附上了 --hard 参数:
bash
git status

git reset --hard HEAD^
你的 HEAD 和当前 branch 切到上一条 commit 的同时,你工作目录里的新改动也一起全都消失了,不管它们是否被放进暂存区:
shell
git status可以看到在 reset --hard 后,所有的改动都被擦掉
reset --soft:保留工作目录和暂存区
reset --soft 会在重置 HEAD 和 branch 时,保留工作目录和暂存区中的内容,并把重置 HEAD 所带来的新的差异放进暂存区。
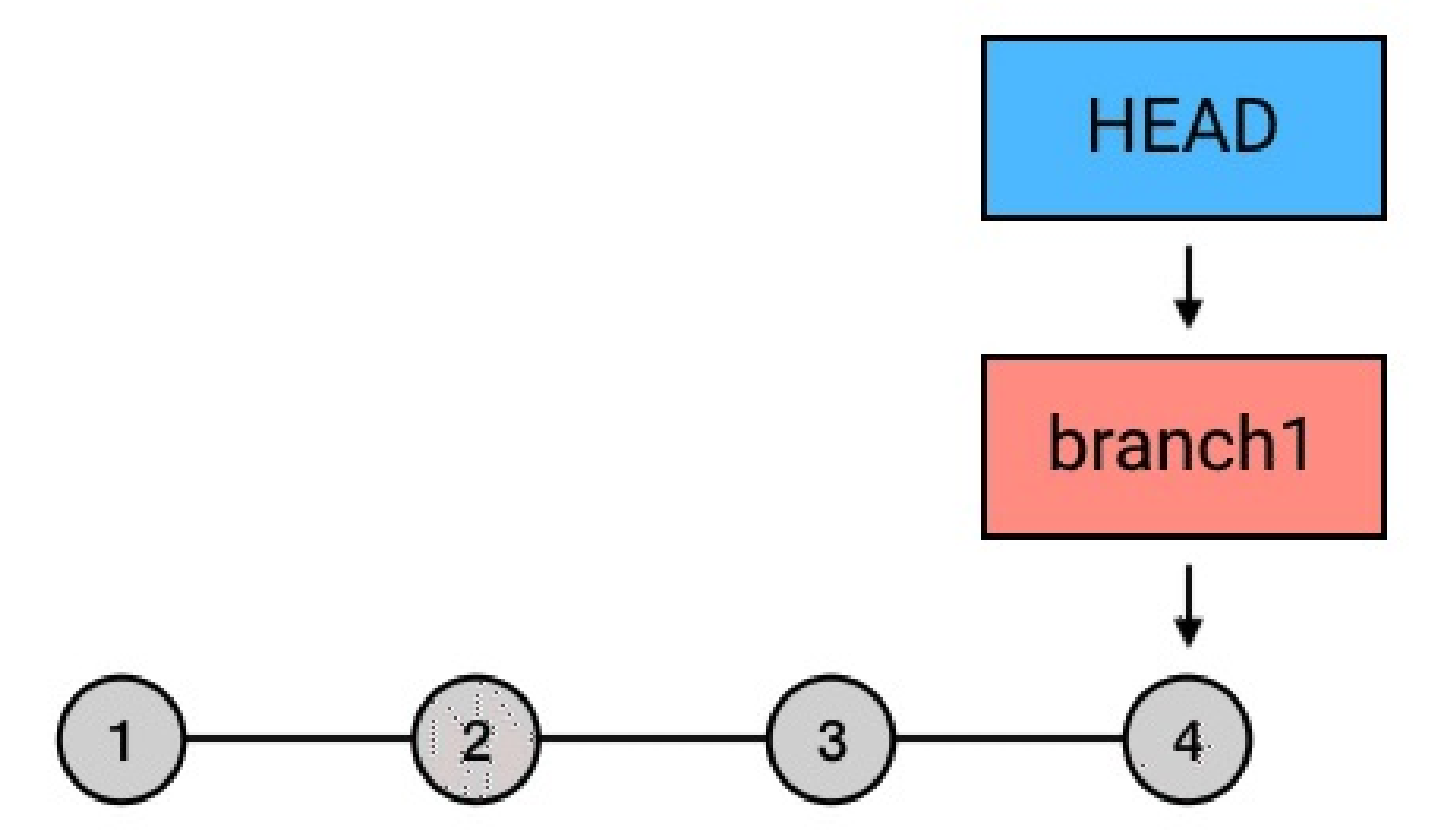
由于 HEAD 从 4 移动到了 3,而且在 reset 的过程中工作目录的内容没有被清理掉,所以 4 中的改动在 reset 后就也成了工作目录新增的「工作目录和 HEAD 的差异」。这就是上面一段中所说的「重置 HEAD 所带来的差异」
--hard 会清空工作目录的改动,而 --soft 则会保留工作目录的内容,并把因为保留工作目录内容所带来的新的文件差异放进暂存区
reset 不加参数:保留工作目录,并清空暂存区
reset 如果不加参数,那么默认使用 --mixed 参数。它的行为是:保留工作目录,并且清空暂存区。也就是说,工作目录的修改、暂存区的内容以及由 reset 所导致的新的文件差异,都会被放进工作目录。简而言之,就是把所有差异都混合(mixed)放在工作目录中
shell
git reset HEAD^工作目录的内容和 --soft 一样会被保留,但和 --soft 的区别在于,它会把暂存区清空:
shell
git statuscheckout 本质
checkout 并不止可以切换 branch。checkout 本质上的功能其实是:签出( checkout )指定的 commit。
git checkout branch名 的本质,其实是把 HEAD 指向指定的 branch,然后签出这个 branch 所对应的 commit 的工作目录。所以同样的 checkout 的目标也可以不是 branch,而直接指定某个 commit:
shell
git checkout HEAD^^

git checkout master~5

git checkout 78a4bc

git checkout 78a4bc^
这些都是可以的,在 git status 的提示语中,Git 会告诉你可以用 checkout -- 文件名 的格式,通过「签出」的方式来撤销指定文件的修改
checkout 和 reset 的不同
checkout 和 reset 都可以切换 HEAD 的位置,它们除了有许多细节的差异外,最大的区别在于:reset 在移动 HEAD 时会带着它所指向的 branch 一起移动,而 checkout 不会。当你用 checkout 指向其他地方的时候,HEAD 和它所指向的 branch 就自动脱离了。
事实上,checkout 有一个专门用来只让 HEAD 和 branch 脱离而不移动 HEAD 的用法:
shell
git checkout --detach执行这行代码,Git 就会把 HEAD 和 branch 脱离,直接指向当前 commit
Git rm 的选项配置和说明
1. -f, --force
强制删除文件,即使它们与暂存区或工作目录中的内容冲突:
bash
git rm -f file.txt2. -r, --recursive
递归删除目录和它们包含的所有文件:
bash
git rm -r directory3. -n, --dry-run
模拟删除文件,但不实际删除它们,可用于预览删除操作将如何影响暂存区:
bash
git rm -n file.txt4. --cached
仅从暂存区中删除文件,保留工作目录中的文件:
bash
git rm --cached file.txt5. --ignore-unmatch
忽略不存在的文件:即使没有文件匹配也不报错,以 0 状态退出:
bash
git rm --ignore-unmatch file.txt6. -q, --quiet
静默模式,不显示每个被删除文件对应的 rm 命令行输出:
bash
git rm -q file.txt7. --pathspec-from-file
从指定的文件中读取要删除的文件的路径:
bash
git rm --pathspec-from-file file.txt一些额外的技巧
- 使用
git rm -h命令查看所有可用选项 - 使用
git rm --help命令查看特定选项的帮助信息
总结
Git 内容非常多,本文我已经尽量克制,可是还是写了二十多节出来。尽管这样,有些很有用的内容我依然没有写出来。因为我写本文的目的是解决大部分人「学不会 Git」和「用了很久却总用不好 Git」这两个问题,所以我在本文里重点讲的也是 Git 的学习和使用中那些既重要又困难的关键点。
如果你在整个阅读过程中是边读边练的,相信读到这里,你对 Git 已经有一个较为全面和深刻的认识了。接下来你只要在平时使用 Git 的过程中多留心一些,找机会把本文中的内容应用在实战,很快就可以成为众人眼中的「Git 高手」了。当然,到时候你也许也会发现,其实大家眼中的「Git 高手」远没有那么神秘,并不一定比别人懂很多,只是更加了解 Git 的工作原理和一些关键概念罢了。
几个「不难但却很有用」的 Git 技能点
除了本文里讲到的那些「关键点」,还有些 Git 的相关知识虽然也比较有用,但属于稍微研究一下就可以学会的内容,我就不讲了,只在这里做一个简单的列举,你在平时使用 Git 的时候记得抽空学习一下就好。
tag:不可移动的 branch
tag 是一个和 branch 非常相似的概念,它和 branch 最大的区别是:tag 不能移动。所以在很多团队中,tag 被用来在关键版本处打标记用。
更多关于 tag:https://git-scm.com/docs/git-tag
cherry-pick:把选中的 commits 一个个合并进来
cherry-pick 是一种特殊的合并操作,使用它可以点选一批 commit,按序合并。
更多关于 cherry-pick:https://git-scm.com/docs/git-cherry-pick
git config:Git 的设置
git config 可以对 Git 做出基础设置,例如用户名、用户邮箱,以及界面的展示形式。内容虽然多,但都不难,整体看一遍,把 Git 设置成你最舒服的样子,从此就再也不用管它了。属于「一次付出,终身受用」的高性价比内容。
更多关于 config:https://git-scm.com/docs/git-config
Git Flow:复杂又高效的工作流
除了前面讲到的 "Feature Branching",还有一个也很流行的工作流:Git Flow。Git Flow 的机制非常完善,很适合大型团队的代码管理。不过由于它的概念比较复杂(虽然难度并不高),所以并不适合新手直接学习,而更适合在不断的自我研究中逐渐熟悉,或者在团队合作中慢慢掌握。基于这个原因,我最终也没有在本文里讲 Git Flow,但我推荐你自己在有空的时候了解一下它。
更多关于 Git Flow:https://www.atlassian.com/git/tutorials/comparing-workflows/gitflow-workflow
以上这几个内容都不难,而且挺有用,所以虽然我没有讲,但都建议你把它们了解一下,会有好处的。
想学习更多的 Git 知识?
如果看完本文觉得不够,希望得到更多的 Git 知识补充,可以到它的官网去查看详细的文档: