缓存
缓存是全栈开发中非常重要的一环,缓存使用好了,特别对于性能的提升往往是立竿见影的;但使用不好就会严重影响系统运行,甚至因为数据一致性问题造成严重的数据错误
缓存的本质
缓存简单说就是为了节约对原始资源重复获取的开销,而将结果数据副本存放起来以供获取的方式
- 首先,缓存往往针对的是“资源” 当某一个操作是“幂等”的和“安全”的,那么这样的操作就可以被抽象为对“资源”的获取操作,那么它才可以考虑被缓存。有些操作不幂等、不安全,比如银行转账,改变了目标对象的状态,自然就难以被缓存
- 其次,缓存数据必须是“重复”获取的 缓存能生效的本质是空间换时间。将曾经出现过的数据以占据缓存空间的方式存放下来,在下一次的访问时直接返回,从而节约了通过原始流程访问数据的时间
- 再次,缓存是为了解决“开销”的问题 这个开销不只时间的开销,还可以是 CPU、网络、I/O 等一切资源。例如在 Web 服务中增加一层缓存,是为了避免了对原始资源获取的时候,对数据库资源调用的开销
- 最后,缓存的存取其实不一定是“更快”的。 有些程序员朋友对缓存访问总有一个比原始资源访问“更快”的概念,但这是不确切的。
缓存使用的动机中有两个使用动机最为常见:
- 一个是 latency 延迟,即追求更低的延迟,这也是“更快”这个印象的由来
- 另一个使用动机是 throughput 吞吐量,即追求更高的吞吐量
比如某个系统,数据在关系数据库中存放,获取速度很快,但是还在 S3 这个分布式文件系统上存放有数据副本,它的访问速度在该系统中要低于数据库的访问速度。某些请求量大的下游系统,会去 S3 获取数据,这样就缓和了前一条提到的数据库“开销”问题,但数据获取的速度却降下来了。这里 S3 存放的数据,也可以成为很有意义的缓存,即便它的存取其实是更慢的。这种情况下,S3 并没有改善延迟,但提供了额外的吞吐量,符合上面提到的第二个使用动机
平时谈论的缓存“更快”访问的场景,这个“快”也是相对而言的,在不同系统中同一对象会发生角色的变化。 例如 CPU 的多级高速缓存,就是内存访问的“缓存”;而内存虽然较 CPU 存取较慢,但比磁盘快得多,因此它可以被用作磁盘的“缓存”介质
缓存无处不在
当浏览器地址栏中输入 URL 按下回车,之后的几秒钟时间里,到底发生了什么。从一个特别的角度——缓存的角度来审视它。
对于地址栏中输入的域名,浏览器需要搞清楚它代表的 IP 地址,才能进行访问。过程如下:
- 它会先查询浏览器内部的“域名-IP”缓存,如果你曾经使用该浏览器访问过这个域名,这里很可能留有曾经的映射缓存
- 如果没有,会查询操作系统是否存在这个缓存,例如在 Mac 中可以通过修改
/etc/hosts文件来自定义这个域名到 IP 的映射缓存 - 如果还没有,就会查询域名服务器(DNS,Domain Name System),得到对应的 IP 和可缓存时间
Linux 或 Mac 系统中,你可以使用 dig 命令来查询:
plain
dig www.baidu.com得到的信息中包含:
plain
;; ANSWER SECTION:
www.baidu.com.		280	IN	CNAME	www.a.shifen.com.
www.a.shifen.com.	199	IN	A	36.155.132.3
www.a.shifen.com.	199	IN	A	36.155.132.76
当请求抵达服务端,在反向代理中也是可以进行缓存配置的,接着请求终于抵达服务端的代码逻辑了,对于一个采用 MVC 架构的应用来说,MVC 的各层都是可以应用缓存模式的
- 对于 Controller 层来说,拦截过滤器就是可以配置缓存来过滤服务的,即满足某些要求的可缓存请求,可以直接通过过滤器返回缓存结果,而不执行后面的逻辑
- 对于 Model 层来说,几乎所有的数据库 ORM 框架都提供了缓存能力,对于贫血模型的系统,在 DAO 上方的 Service 层基于其暴露的 API 应用缓存,也是一种非常常见的形式
- 对于 View 层,很多页面模板都支持缓存标签,页面中的部分内容,不需要每次都执行渲染操作(这个开销很可能不止渲染本身,还包括需要调用模型层的接口而造成显著的系统开销),而可以直接从缓存中获取渲染后的数据并返回
当页面 HTML 返回了浏览器,还需要加载页面上需要的大量资源,包括 CSS、JavaScript、图像等等,都是可以通过读取浏览器内的缓存,而避免一个新的 HTTP 请求的开销的。通过服务端设置返回 HTTP 响应的 Cache-Control 头,就可以很容易做到这一点。例如:
plain
Cache-Control: public, max-age=86400上面这个请求头就是说,这个响应中的数据是“公有”的,可以被任意级节点(包括代理节点等等)缓存最多 86400 秒(一天)
即便某资源无法被缓存,必须发起单独的 HTTP 请求去获取这样的资源,也可以通过 CDN 的方式,去较近的资源服务器获取,而这样的资源服务器,对于分布式网络远端的中心节点来说,就是它的缓存
缓存应用模式
Cache-Aside
这是最常见的一种缓存应用模式,整个过程也很好理解
数据获取策略:
- 应用先去查看缓存是否有所需数据
- 如果有应用直接将缓存数据返回给请求方
- 如果没有,应用执行原始逻辑,例如查询数据库得到结果数据
- 应用将结果数据写入缓存
多数缓存,例如前面提到的拦截过滤器中的缓存,基本上都是按照这种方式来配置和使用的
数据读取的异常情形:
- 如果数据库读取异常,直接返回失败,没有数据不一致的情况发生
- 如果数据库读取成功,但是缓存写入失败,那么下一次同一数据的访问还将继续尝试写入,因此这时也没有不一致的情况发生
可见,这两种异常情形都是“安全”的
数据更新策略:
- 应用先更新数据库
- 应用再令缓存失效
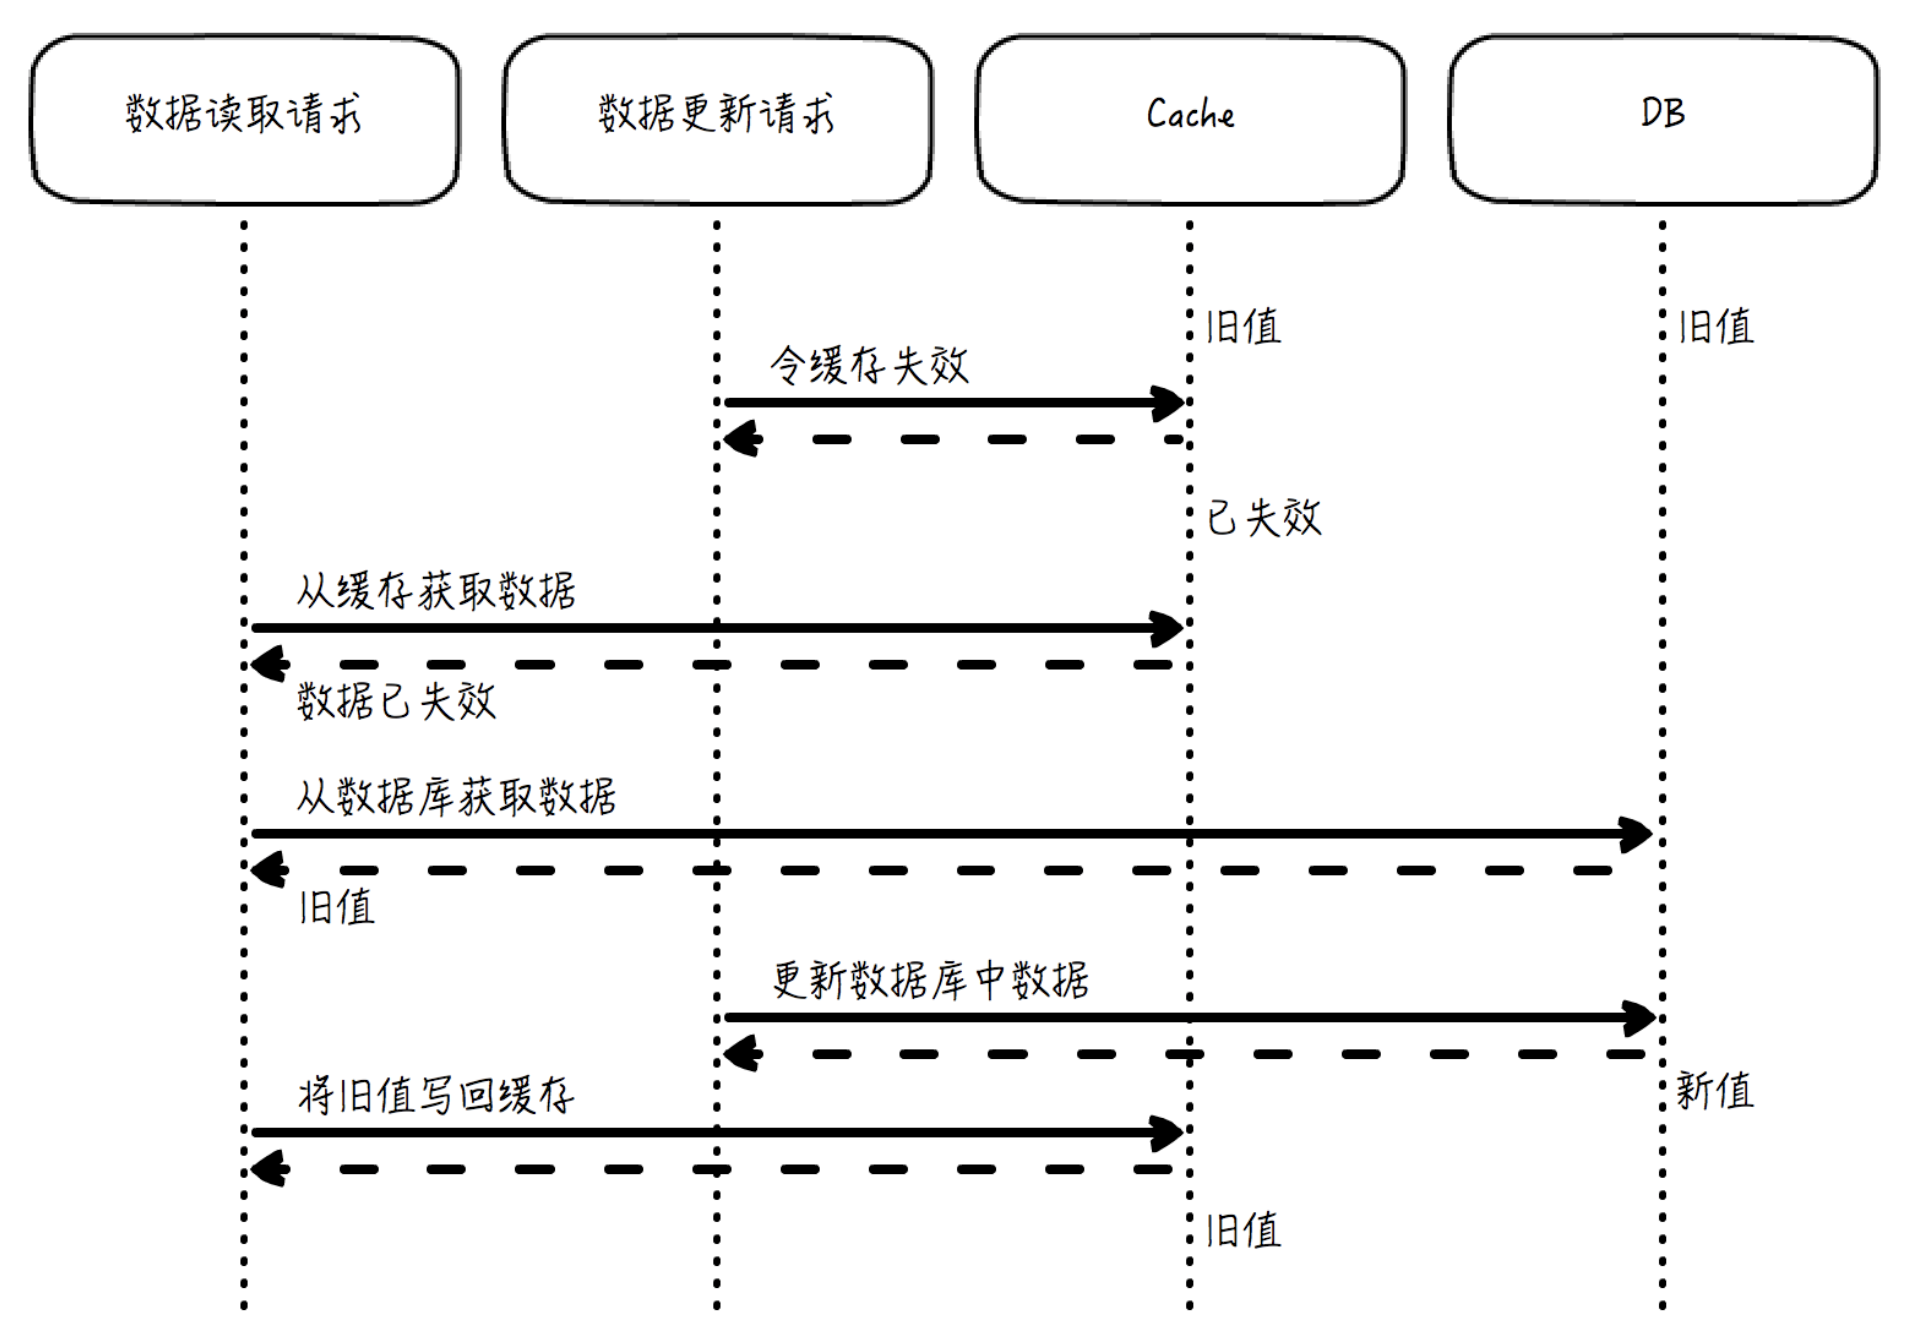
数据库更新以后,需要令缓存失效,而不是更新缓存为数据库的最新值。
如果两个几乎同时发出的请求分别要更新数据库中的值为 A 和 B,如果结果是 B 的更新晚于 A,那么数据库中的最终值是 B。但是,如果在数据库更新后去更新缓存,而不是令缓存失效,那么缓存中的数据就有可能是 A,而不是 B。因为数据库虽然是“更新为 A”在“更新为 B”之前发生,但如果不做特殊的跨存储系统的事务控制,缓存的更新顺序就未必会遵从“A 先于 B”这个规则,这就会导致这个缓存中的数据会是一个长期错误的值 A
如果是令缓存失效,这个问题就消失了。因为 B 是后写入数据库的,那么在 B 写入数据库以后,无论是写入 B 的请求让缓存失效,还是并发的竞争情形下写入 A 的请求让缓存失效,缓存反正都是失效了。那么下一次的访问就会从数据库中取得最新的值,并写入缓存,这个值就一定是 B
数据更新的异常情形:
- 如果数据库操作失败,那么直接返回失败,没有数据不一致的情况发生;
- 如果数据库操作成功,但是缓存失效操作失败,这个问题很难发生,但一旦发生就会非常麻烦,缓存中的数据是过期数据,需要特殊处理来纠正
Read-Through
这种情况下缓存系统彻底变成了它身后数据库的代理,二者成为了一个整体,应用的请求访问只能看到缓存的返回数据,而数据库系统对它是透明的
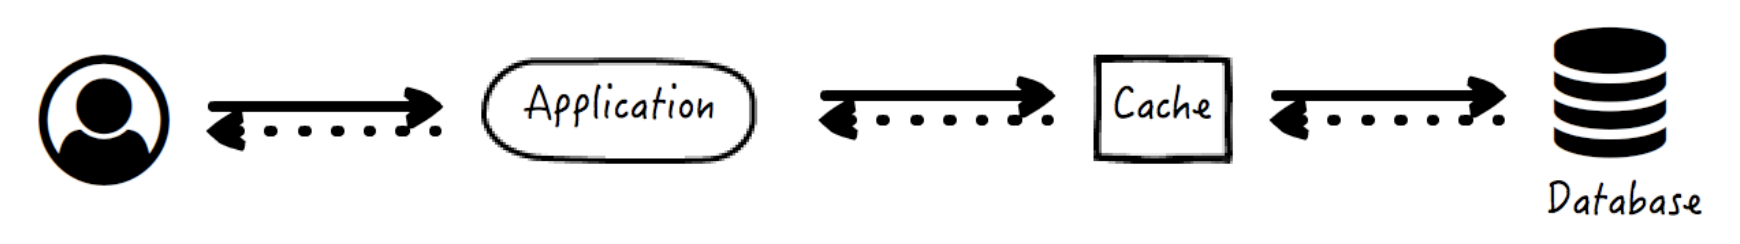
有的框架提供的内置缓存,例如一些 ORM 框架,就是按这种 Read-Through 和 Write-Through 来实现的。
数据获取策略:
- 应用向缓存要求数据
- 如果缓存中有数据,返回给应用,应用再将数据返回
- 如果没有,缓存查询数据库,并将结果写入自己
- 缓存将数据返回给应用
数据读取异常的情况分析和 Cache-Aside 类似,没有数据不一致的情况发生
Write-Through
和 Read-Through 类似,图示同上,但 Write-Through 是用来处理数据更新的场景。
数据更新策略:
- 应用要求缓存更新数据
- 如果缓存中有对应数据,先更新该数据
- 缓存再更新数据库中的数据
- 缓存告知应用更新完成
这里的一个关键点是,缓存系统需要自己内部保证并发场景下,缓存更新的顺序要和数据库更新的顺序一致。 比如说,两个请求分别要把数据更新为 A 和 B,那么如果 B 后写入数据库,缓存中最后的结果也必须是 B。这个一致性可以用乐观锁等方式来保证
数据更新的异常情形:
- 如果缓存更新失败,直接返回失败,没有数据不一致的情况发生
- 如果缓存更新成功,数据库更新失败,这种情况下需要回滚缓存中的更新,或者干脆从缓存中删除该数据
还有一种和 Write-Through 非常类似的数据更新模式,叫做 Write-Around。它们的区别在于 Write-Through 需要更新缓存和数据库,而 Write-Around 只更新数据库(缓存的更新完全留给读操作)
Write-Back
对于 Write-Back 模式来说,更新操作发生的时候,数据写入缓存之后就立即返回了,而数据库的更新异步完成。这种模式在一些分布式系统中很常见
这种方式带来的最大好处是拥有最大的请求吞吐量,并且操作非常迅速,数据库的更新甚至可以批量进行,因而拥有杰出的更新效率以及稳定的速率,这个缓存就像是一个写入的缓冲,可以平滑访问尖峰。另外,对于存在数据库短时间无法访问的问题,它也能够很好地处理
但是它的弊端也很明显,异步更新一定会存在着不可避免的一致性问题,并且也存在着数据丢失的风险(数据写入缓存但还未入库时,如果宕机了,那么这些数据就丢失了)
缓存使用的问题
缓存穿透
缓存穿透 指的是在某些情况下,大量对于同一个数据的访问,经过了缓存屏障,但是缓存却未能起到应有的保护作用
举例来说,对某一个 key 的查询,如果数据库里没有这个数据,那么缓存中也没有数据的存放,每次请求到来都会去查询数据库,缓存根本起不到应有的作用
当然,这个问题也不难解决,比方说可以在缓存中对这个 key 存放一个空结果,毕竟“没有结果”也是结果,也是需要缓存起来的。还有一种缓解方法是使用 布隆过滤器 等数据结构,在数据库查询之前,预先过滤掉某些不存在的结果
还有一种特殊情况也会造成缓存穿透的严重后果。一般的缓存策略下,往往需要先发生一次缓存命中失败,接着从实际存储(比如数据库)中得到结果,再回填到内存缓存中。但是,如果这个数据库查询过程比较慢,大量同一数据的请求像雨点一样几乎同时到来,就会全部穿透缓存,一并落到了数据库上,而那个时候最早的那个请求引发的缓存回填甚至都还没有发生,在这种情况下数据库直接就挂掉了,虽然缓存的机制本身看起来并没有任何问题。
这种问题在某些时间窗口敏感的高并发系统中可能出现,解决方法有这样两种
- 一种是以流量控制的方式,限制对于同一数据的访问,必须等到前一个完成以后,下一个才能进行,即如果缓存失效而引发的数据库查询正在进行,其它请求就得老老实实地等着。这种方法通用性好,但这个等待机制可能较为复杂,且有可能影响用户体验。
- 另一种方法是缓存预热,在大批量请求到来以前,先主动将该缓存填充好。这种方法操作简单高效,但局限性是需要提前知道哪些数据可能引发缓存穿透的问题
注:按《分布式缓存》篇的分类口径,“热点数据失效瞬间大量并发回源”的场景通常称为缓存击穿(解法是互斥重建/逻辑过期);本节把它作为“缓存未起到屏障作用”的广义现象来讨论,两者的解决方案是一致的。
缓存雪崩
原本起屏障作用的缓存,如果在一定的时间段内,对于大量的请求访问失效,即失去了屏障作用,造成它后方的系统压力过大,引起系统过载、宕机等问题,就叫做缓存雪崩。
有一次 Amazon 机房突然断电,在恢复的时候把网页服务器都通上了电,这时候缓存服务几乎还没有缓存数据,缓存命中率几乎为零,于是大量的请求冲向数据库,直接把数据库冲垮了。外在的表现就是,断电导致网站无法提供服务,短期内访问恢复,随后又丧失服务能力
总能看到很多技术报告里面写:平均的缓存命中率能够达到百分之九十多,可以飙到多少多少的 TPS,为此可以节约多少多少硬件成本。初看这样的设计真不错,但是很容易忽视的一点是:这样的数据是建立在足够长的时间以及足够多的统计数据的基础之上的,但是在单个时间段内,由于缓存雪崩效应,缓存命中率可以低到难以承受的地步,导致底层的数据服务直接被冲垮
对于 这种类型的雪崩,最常见的解决方法无非还是限流、预热两种
回到 Amazon 那个问题,当时的解决方法就是——限流。当时整个系统对于单台机器的限流已经做得比较好了,后来工程师一台一台逐步启动,每启动一台机器,就等一会,等到缓存数据填充并稳定以后,再启动下一台,这样最多也就是单台机器的所有请求全部发生了穿透,这个数量就小得多了,数据库也是可以正常负载的。
另外一个常见的缓存雪崩场景是:缓存数据通常都有过期时间的,如果缓存加载的时间比较集中,那么很可能到了某一时间点,大量的缓存就会同时过期,于是对应这些数据的请求全部落到了后面的数据库上,从而造成系统崩溃。这个问题解决起来也不难,那就是避免缓存集中写入的时间,如果无法避免,就使用一个范围随机数来均匀地分散过期时间,从而打散缓存过期对系统造成的压力
缓存容量失控
刚工作不久的时候,我参与做过这样一个系统,用户的行为需要被记录到数据库里,但是每条记录发生的时候都写一次数据库的话开销就太大了,于是有同事设计了一个链表:
- 用户的行为首先会被即时记录到内存链表里面去;
- 每 10 分钟从链表往数据库里面集中写一次数据,然后清空链表内的数据。
看起来这就像是 Write-Back 模式,看起来也确实可以实现需求。可是上线没多久系统就挂掉了
- 清空链表数据是使用时间条件触发的任务来完成, 通过时间因素来限制空间大小,远不如通过队列长度来限制空间大小来得可靠。 换句话说,如果这 10 分钟内事件暴增,链表就很容易变得非常大。 这个变化范围取决于请求的上限,而不是在缓存系统自己的掌控中
- 清空链表的任务,如果在执行的过程中出现了异常,甚至仅仅是处理速度受到阻塞,那就会直接导致链表数据无法得到清空,甚至越积越多。实际上, 链表清空数据并写入数据库是一个耗时的异步行为,这是另一个受控性较差的点。 在使用异步系统批量写入数据的时候,一定要考虑这个潜在的危险
这些问题当然在明确的情况下可以得到规避,但是毫无疑问,这样的设计充满了潜在的危险。事实上,最终这样的问题也确实发生了,二者相加导致的结果是链表巨大,撑死了整个系统、OOM,系统失去响应。
因此对于缓存容量的控制,最好是基于缓存容量本身来直接控制,但是考虑到某些编程语言的自身限制,比如 Java,从内存消耗的角度来实现不方便,那么就可以通过基于队列的长度来替代实现
LRU 的致命缺陷
LRU 指的是 Least Recently Used,最近最少使用算法。这是缓存队列维护的最常见算法,原理是:维护一个限定最大容量的队列,队列头部总是放置最近访问的元素(包括新加入的元素),而在超过容量限制时总是从队尾淘汰元素。
用这样的方式,来解释 LRU 的工作原理:
假设用这个缓存的 LRU 队列来存储城市信息,且队列容量只有 2
- 第一步,用户访问上海信息,上海节点被加入队列
- 第二步,用户访问北京信息,北京节点从队列头部加入,上海相应地被往尾部推
- 第三步,用户又访问上海信息,上海被挪到头部
- 第四步,用户访问天津信息,从头部加入队列后,队列长度超出容量 2,因此从尾部将北京挤出缓存队列
看起来是个很完美的缓存淘汰算法,在队列较长时,总是能保证最近访问的数据位于队列的头部,而在需要从缓存中淘汰数据时,总是能从尾部淘汰最不常用的那一个。但是如果用户有意无意地访问一些错误信息,就会破坏掉这个 LRU 队列中最近访问数据的真实性。
在实际项目中遇到过这样一个问题,由于搜索引擎的多个并行爬虫在短时间内访问网站并抓取一些冷门页面,这时候这个 LRU 队列中就存储了相关的冷门数据信息。接着网站活动开启的时间到了,用户量很快就上来了,这时候大量的数据访问全部穿透缓存,导致数据库压力剧增,网站响应时间一下就飙升到了告警线之上
有多种算法可以作为 LRU 的改进方案,比如 LRU-K。就是主缓存队列排的是“第 K 次访问的元素”,也就是说,如果访问次数小于 K,则在另外的一个“低级”队列中维护,这样就保证了只有到达一定的访问下限才会被送到主 LRU 队列中
这种方法保证了偶然的页面访问不会影响网站在 LRU 队列中应有的数据分布。再进一步优化,可以将两级队列变成更多级,或者是将低级队列的策略变成 FIFO(2Q 算法)等等,但原理是不变的
缓存框架
集成方式
在上面介绍了 Web 应用 MVC 的三层都可以集成缓存能力。缓存功能具体怎样整合集成到 Web 应用中,每一种方式都意味着一个切入点
方式 1:编程方式
这种是最常见的方式,使用编程的方式来获取缓存数据。这种方式比较灵活,对于代码往往以 Cache-Aside 模式应用。以 Java 世界应用最广泛的缓存框架 Ehcache 为例,示例代码片段如下:
java
Cache<String, City> cityCache = cacheManager.createCache("cityCache", CacheConfigurationBuilder.newCacheConfigurationBuilder(String.class, City.class, resourcePools));
cityCache.put("Beijing", beijingInfo);
City beijing = cityCache.get("Beijing");
这里建立了一个城市的缓存,key 为城市名称,value 为城市对象,存取操作和对普通 Map 的操作相比,没有区别。
方式 2:方法注解
这种方式的好处在于,可以对方法的调用保持透明,不需要使用单独的缓存代码去分散对业务逻辑的专注。且看下面的例子:
java
@Cacheable(value="getCity", key="#name")
public City getCity(String name) { ... }
这种方式下,同名、同参数方法的再次调用,就可以命中缓存而直接返回。
方式 3:配置文件的注入
这种也比较常见,比如 MyBatis 在 mapper 标签中可以指定 cache 标签,通过这种方式就可以把选定的缓存框架注入到这个持久层框架中。对于指定映射的数据,再次访问时会优先从缓存中查找,这种应用方式就是前一讲我们提到的缓存应用模式中的 Read/Write-Through 模式。
java
<mapper namespace="..." >
  <cache type="org.mybatis.caches.ehcache.EhcacheCache"/>
  ...
</mapper>
方式 4:Web 容器的 Filter
在 Ehcache 2 中,可以配置 net.sf.ehcache.constructs.web.filter.SimplePageCachingFilter 这样一个 filter 到 Tomcat 的 web.xml 中,再配合 filter 的映射匹配参数和初始化参数,就可以实现整个请求的过滤功能。
在 Ehcache 3 中,这个类被取消了,因为它的业务性过于具体,不符合 Ehcache 的设计原则。但是,你依然可以在 filter 里面,以前面提到的编程方式很容易地实现对于完整请求的缓存
方式 5:页面模板中的 Cache 标签
这种方式相对比较少见,有一些页面模板支持 Cache 标签或表达式语法(例如 Django 中,它被称为 Template Fragment Caching),在标签属性或语法参数中可以指定缓存的时间和条件,标签内部的 HTML 将被缓存起来,以避免在每次模板渲染时都去执行其中的逻辑
核心要素
要素 1:缓存数据的生命周期管理
缓存框架不只提供了一个简单的容器,还提供了使容器中的数据进行变动的能力,比如数据可以创建、更新、移动以及淘汰。且看 Ehcache 官网 上的这张示意图:
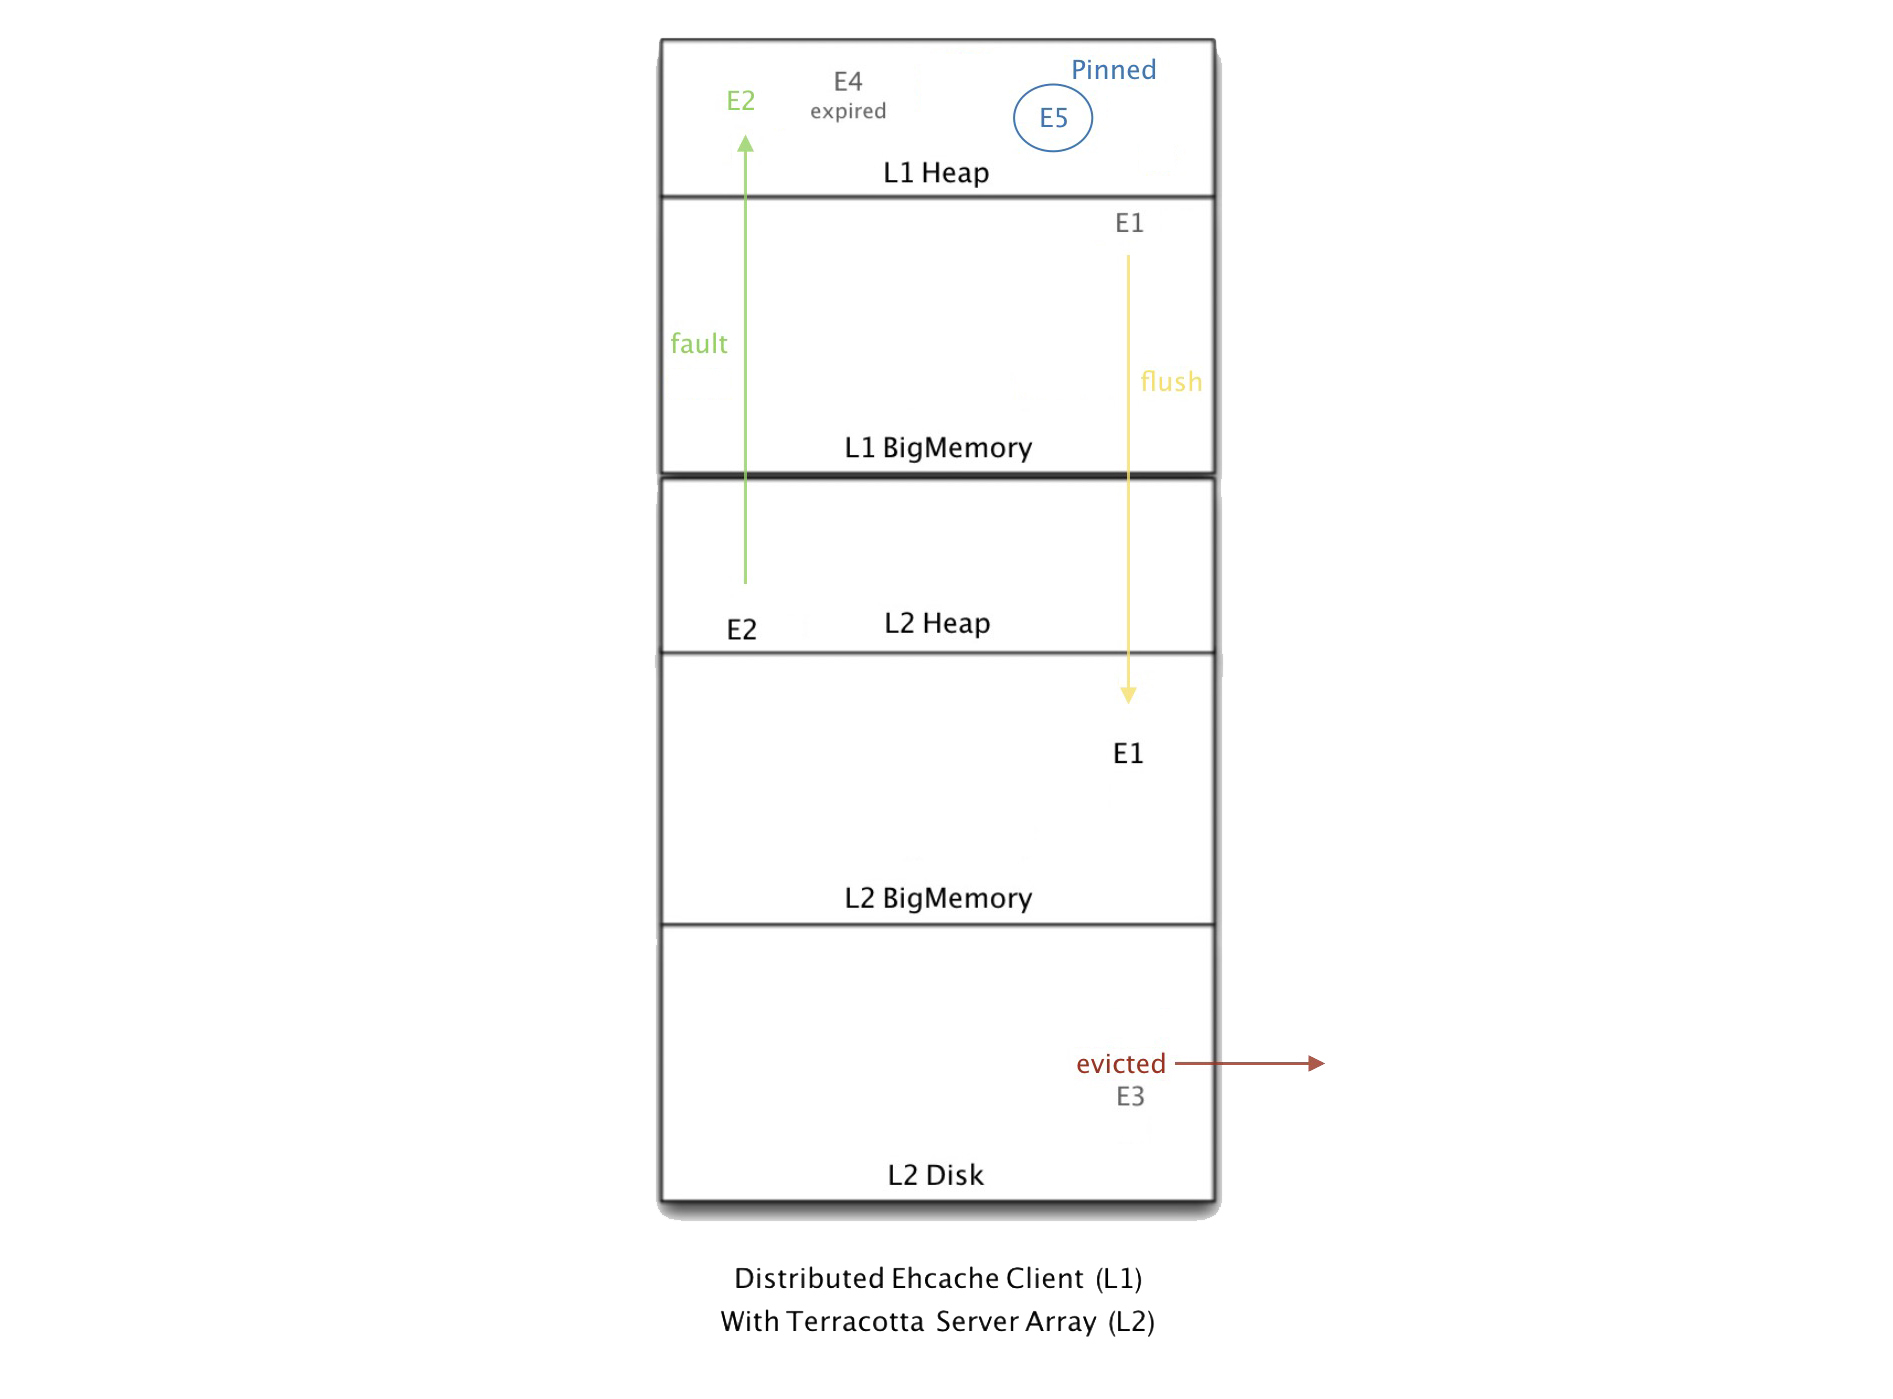
整个容器是分层的,从上到下分别为 L1 Heap、L1 BigMemory、L2 Heap、L2 BigMemory 和 L2 Disk,级别依次降低。这里面定义了几种不同的行为,来反映数据的流动:
- Flush 右侧黄色的箭头,数据从高层向低层移动
- Fault 左侧绿色箭头,数据从低层拷贝到高层,但不删除
- Eviction 下方红色箭头,数据永久淘汰出缓存数据容器
- Expiration 上方烟灰色图案,数据过期了,意味着可以被 flushed 或者 evicted,但是考虑到性能,不一定立即执行这个操作
- Pinning 右上角蓝色图案,数据被强制钉在某一层,不受流动规则控制
要素 2:数据变动规则
上面这些基本数据变动的“行为”,是属于系统侧的定义,只有它们,缓存系统是无法工作的。我们必须有规则,执行规则,才会触发上面的不同行为,引起数据真正的变动
比如说,当一个热点数据因为最近没有访问而从 L1 Heap 挤出去的时候,Flush 行为发生了;在 L2 Disk 上的数据一直没有被访问,超过了期限,淘汰出容器。这样,这些缓存数据变动的具体行为就得到了解释,而这正是由我们预先定义好的“规则”所决定的(这里的算法不一定只是缓存队列的淘汰算法,正如你所见,淘汰可以只是多个数据变动行为中的一个而已)
要素 3:核心 API
这里本质上反映的是缓存框架实现的时候,核心代码结构的设计。当我们把这类的代码结构设计进一步上升到规范层面,它们就可以被定义成接口,即允许不同的缓存框架可以实现同样的设计,在 Java 中,这个东西有一个官方 JSR 的版本 JSR-107。它定义了 CachingProvider、CacheManager、Cache、Cache.Entry 等几个接口
要素 4:用户侧 API
这是指暴露给用户访问缓存的接口,比如常见的向缓存内放置一条数据的接口,或者从缓存内取出一条数据的接口。值得一提的是,我们通常见到的用户 API 都是 Map-like 的结构,即众所周知的 key-value 形式,但其实缓存框架完全可以支持其它的形式,这取决于数据访问的方式,因此这并不是一个绝对的限制