文件系统
本文整理单机文件系统的底层实现(FAT、inode、日志文件系统),并以 MySQL 索引说明 B 树/B+ 树的设计权衡,最后介绍分布式文件系统(HDFS/GFS)的抽象与读写模型。
一、硬盘分块
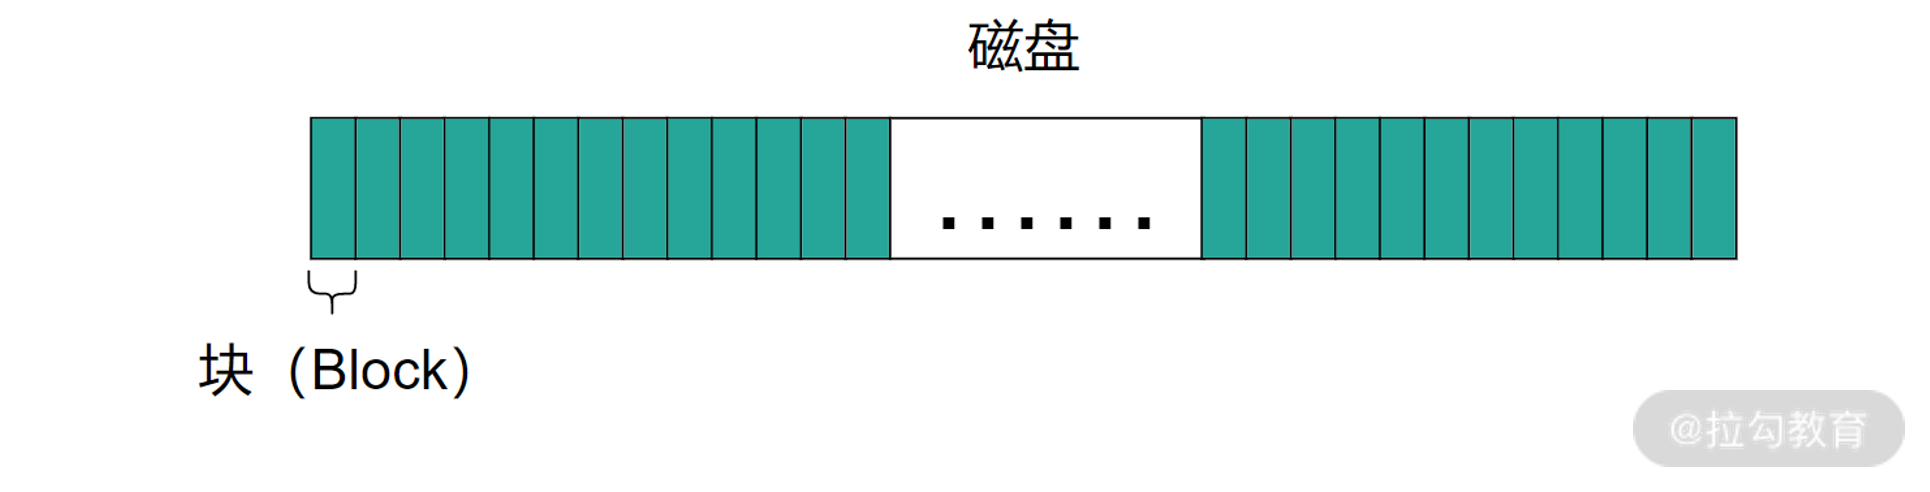
硬盘读写不支持字节级随机存取,且速度远慢于内存(机械盘慢百万倍,SSD 慢数十到数百倍,NVMe 仍有差距)。为提升性能,物理存储被切分为等大的块(如 4KB),通过块序号即可计算物理位置,便于分配、回收与 DMA 批量传输。
二、文件的底层实现
FAT 表
文件分配表(File Allocation Table,FAT)用一个类似链表的结构描述文件对应的块。文件从某块开始,块中存放下一块的序号,序列以 -1 结束。
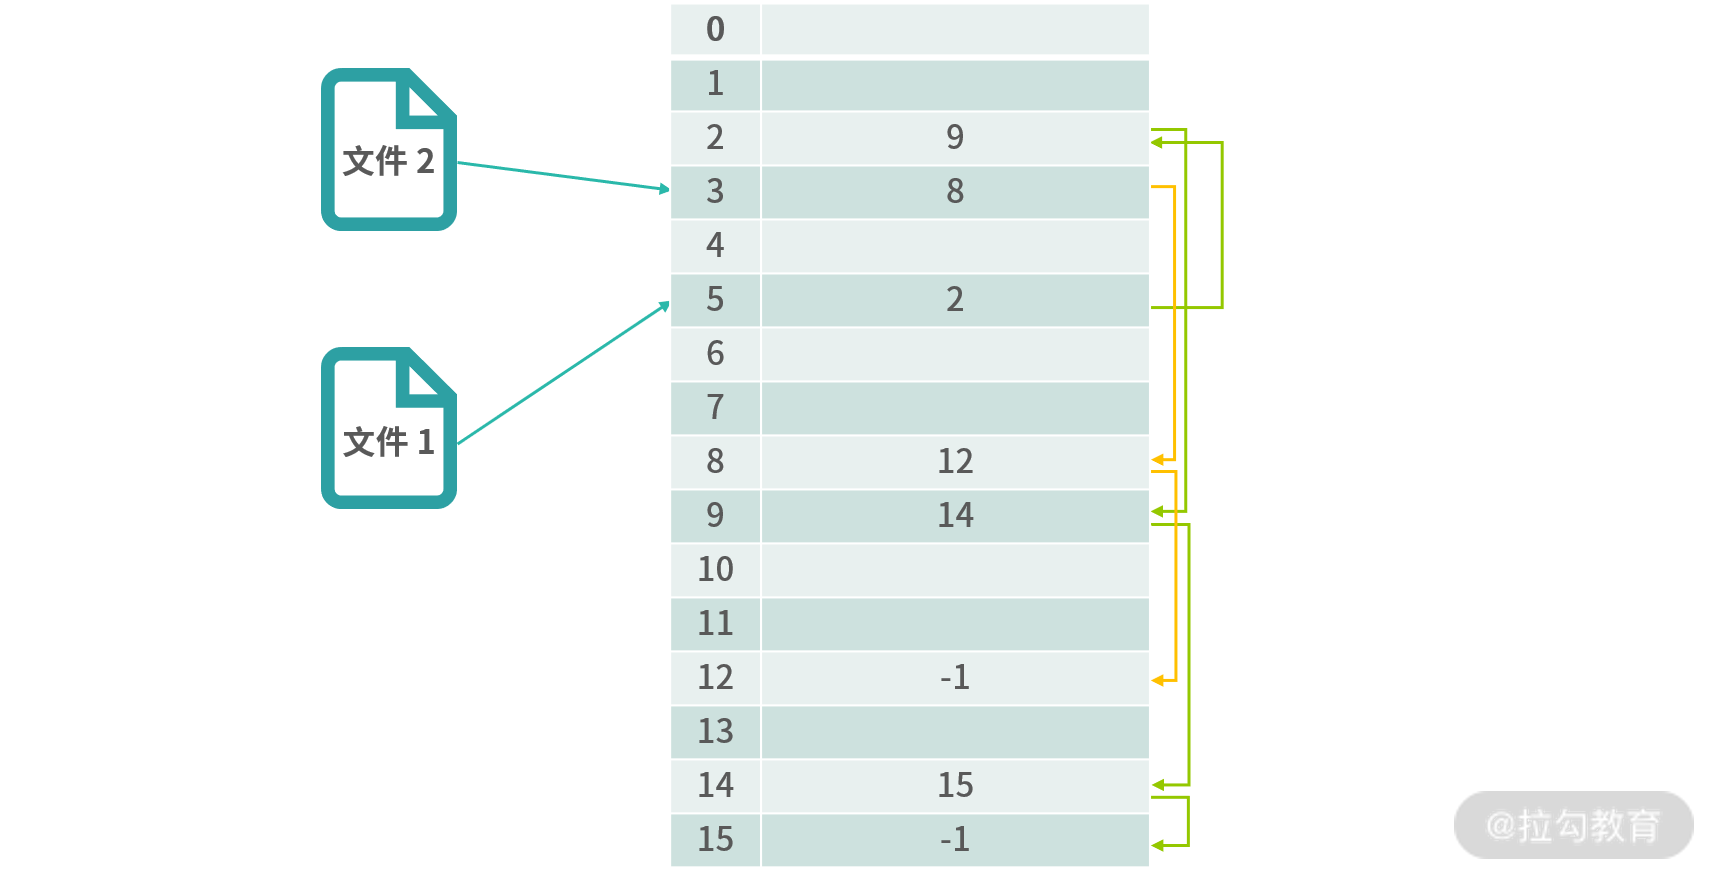
例:文件 1 的链为 5 → 2 → 9 → 14 → 15 → -1,对应块 {5,2,9,14,15}。FAT 算法简单,至今 Windows/Linux/macOS 仍支持。缺陷是 FAT 需整体驻留内存:1T 硬盘、1K 块需 1G 条目,叠加元数据需 2~3G 内存,容量扩展性差。
索引节点(inode)
为每个文件增设 inode,仅在使用时随虚拟内存载入,包含文件属性与物理块位置;大文件通过指针块链式扩展。
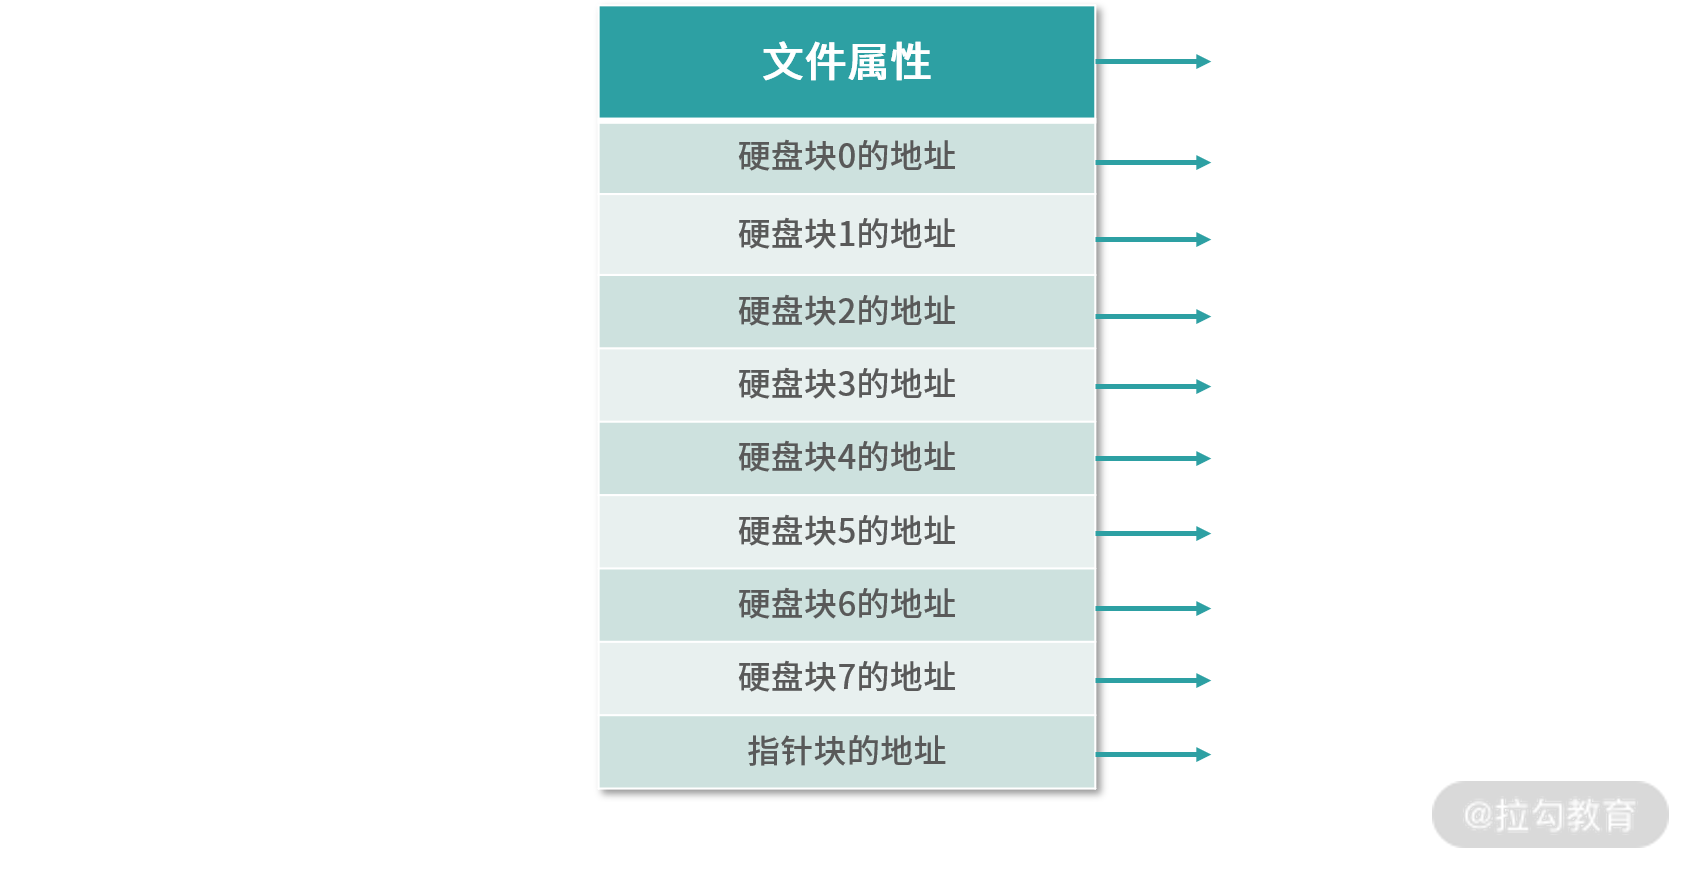
相比 FAT,inode 只需为在用文件建立结构,随页表置换,解决了容量限制,沿用至今。
目录与链接
目录是特殊文件,每个目录有自己的 inode,目录内容存放其下文件的 inode 指针;文件名放在目录而非 inode 中,以支持别名与多目录共享(硬链接)。
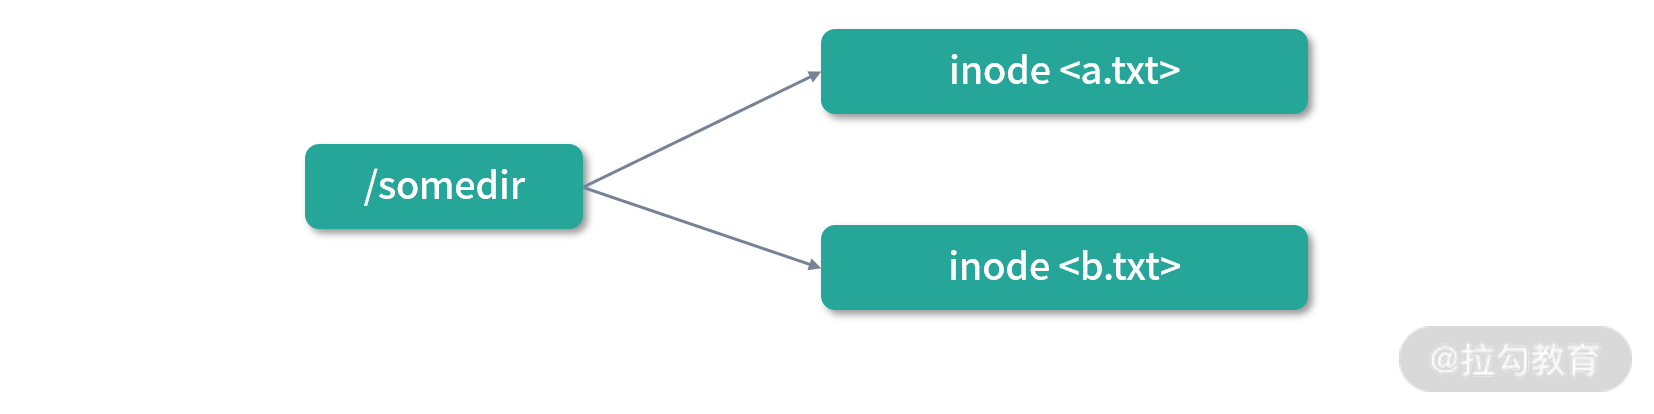
- 硬链接:多文件名共享同一 inode,地位平等;需删除所有硬链接才回收 inode(
ln a b)。 - 软链接:拥有自己的 inode,内容是目标路径快捷方式(
ln -s a b);删除目标后链接失效但自身仍在。
写入第 N 字节的典型步骤:修改内存数据 → 计算目标块 → 查 inode 定位真实块序号 → 整块写回磁盘。
三、日志文件系统
传统实现每次写入都持久化,磁盘(尤其写)成为瓶颈,并易因写中断导致数据损坏或不一致。日志文件系统引入缓冲区 + 日志:
- 写操作先入内存缓冲区,定时批量写入磁盘;
- 磁盘中存储的是变更日志(如
A=1 / A=2 / A=3),读时内存还原; - 日志追加写入,无需覆盖,配合缓冲区可大幅加速写入。
为容灾,引入还原点(Checkpoint):每段时间日志写入一段连续块,写入中涂红、完成涂绿;读入时绿色应用、红色丢弃。区间越小风险粒度越细。
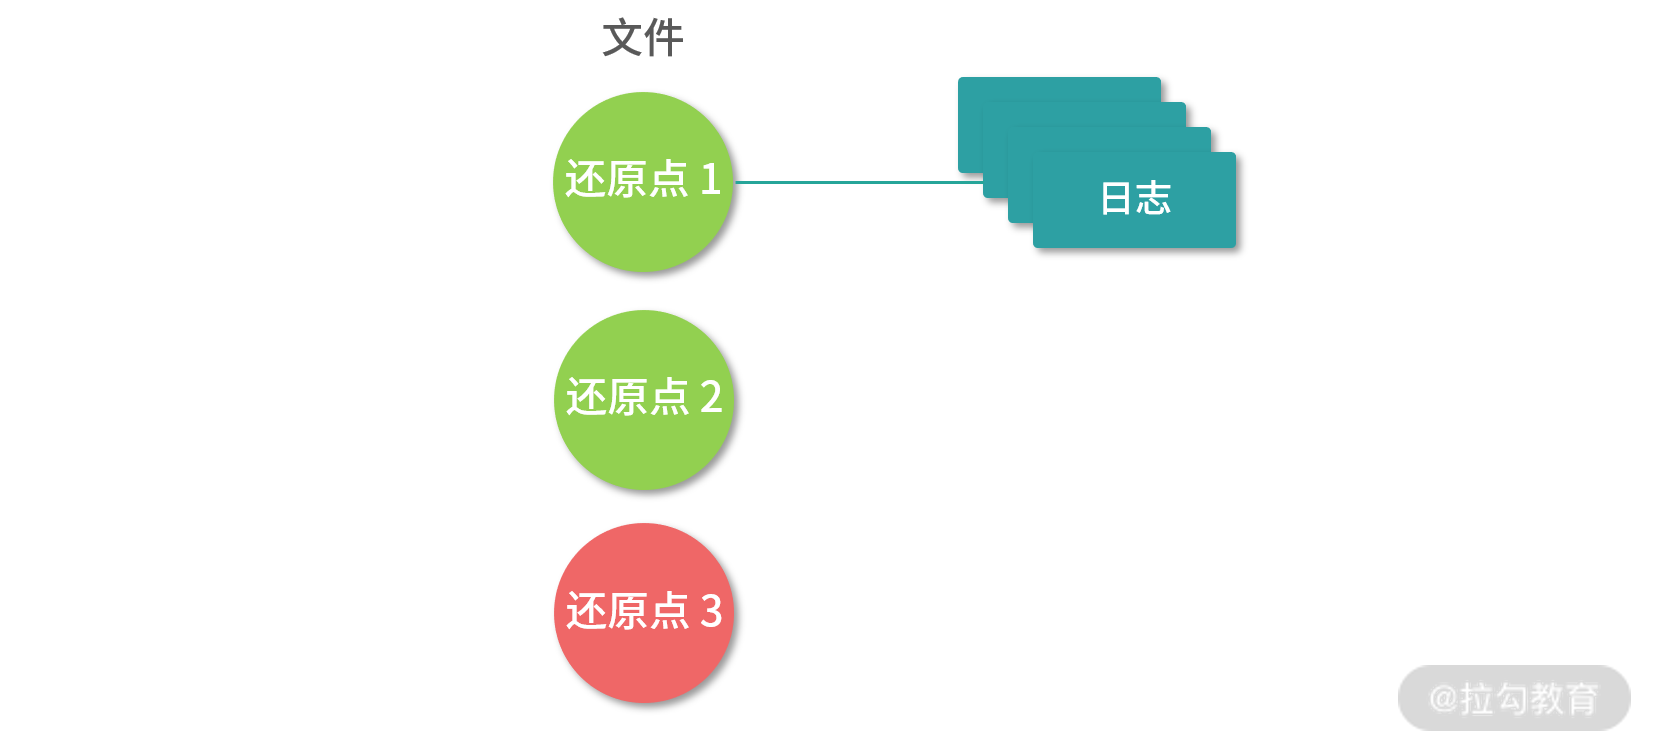
NTFS、Ext3/4 均为日志文件系统(Ext2 无日志)。该思想广泛用于分布式系统(MySQL binlog、Redis AOF、ZooKeeper 等)。
四、数据库文件系统实例:B 树与 B+ 树
行存储与列存储
- 行存储:记录连续排列,单条更新集中在一块,适合事务;聚合查询需跨块,查询慢。
- 列存储:同列数据聚集,时间戳等可整体 DMA 映射,范围/聚合查询快;更新需多处写,不适合事务。
两者最终都落盘到块。
索引与二叉搜索树
索引是"为加速查询而冗余维护的排序数据"。在数据量大到无法整树载入内存时,二叉搜索树每次下探都要读不同磁盘块,I/O 成本高。
B 树 / B+ 树
B 树(B-Tree)让每个节点携带多个索引、子节点更多,树更矮,减少磁盘访问次数。节点内用分隔值对子树区间分段。

B+ 树继承自 B 树,仅叶子节点映射数据,非叶子节点为冗余索引(仅划定子树范围):

B+ 树优势:
- 插入/删除更快:删除常只需动叶子节点;插入仅沿一条路径拆分,自动平衡;
- 范围查找快:所有叶子节点由链表串联,范围/聚合查询沿链表遍历即可,无需回溯。
B 树无冗余、删除根节点可能触发复杂变形,故实战多用 B+ 树。
五、分布式文件系统(HDFS / GFS)
起源与模型
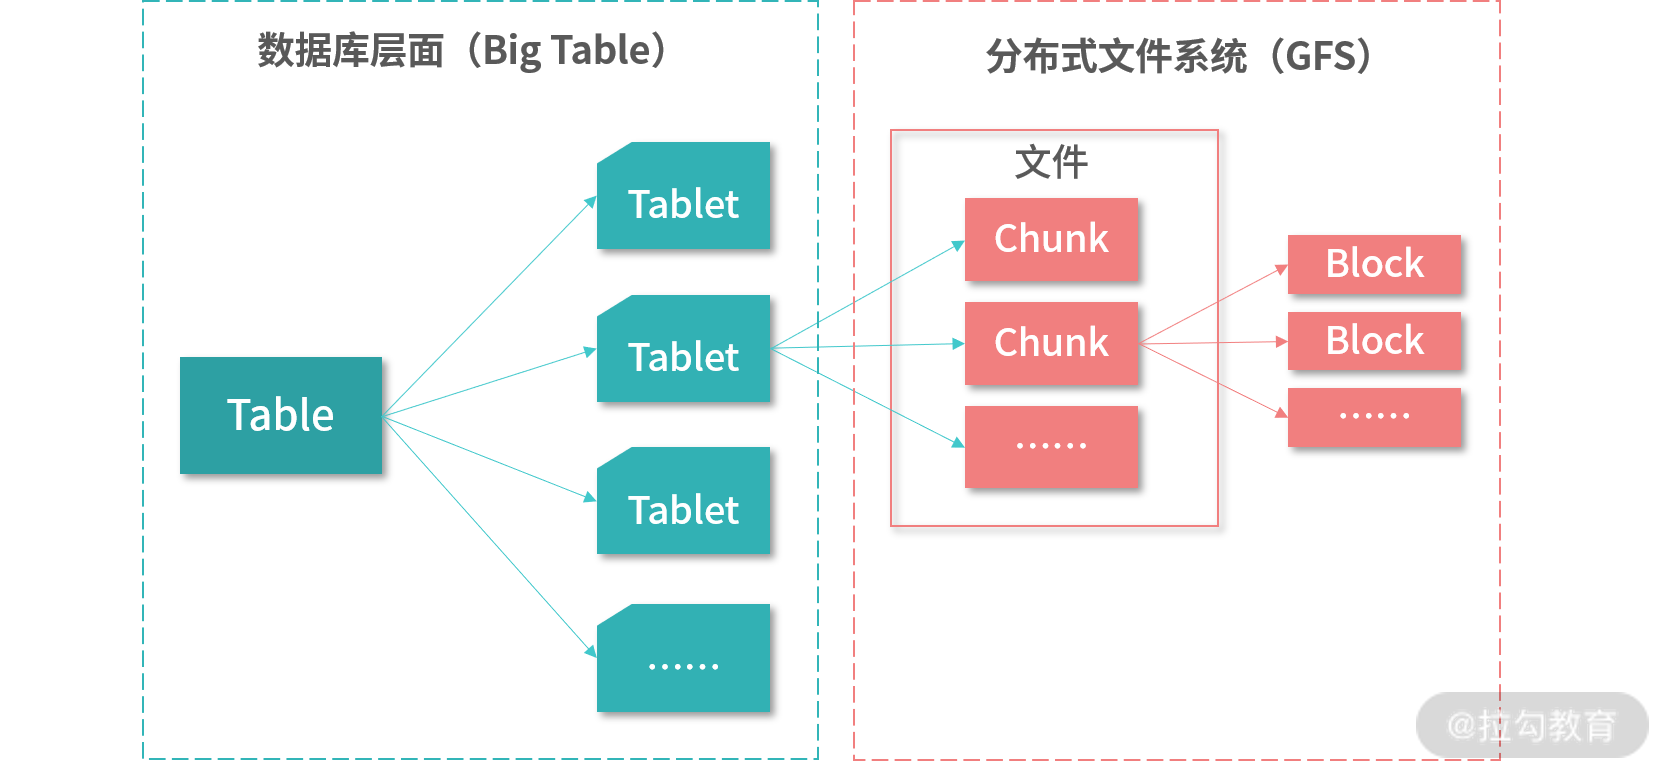
Google File System(GFS)是分布式文件系统原型,HDFS 是其重要实现;BigTable 是构建于 GFS 之上的分布式数据库。搜索网页存储场景:行数固定但列不固定(外链数量不定、带版本),故采用 Key-Value(Map)模型,Key 为 <URL, 列族:列标识, 时间戳> 三元组。
- 用 URL 作为行索引,基于 B+ 树(字典序)建 URL→行号索引;
- 行内可列存储,或大表先按行水平分片(Tablet)。
分片(Tablet)与块(Chunk)
- Tablet:若干相邻字典序行组成,作为数据分布最小单位;每个 Tablet 对应分布式文件中的一个文件,至少 2 副本(3 份数据)。
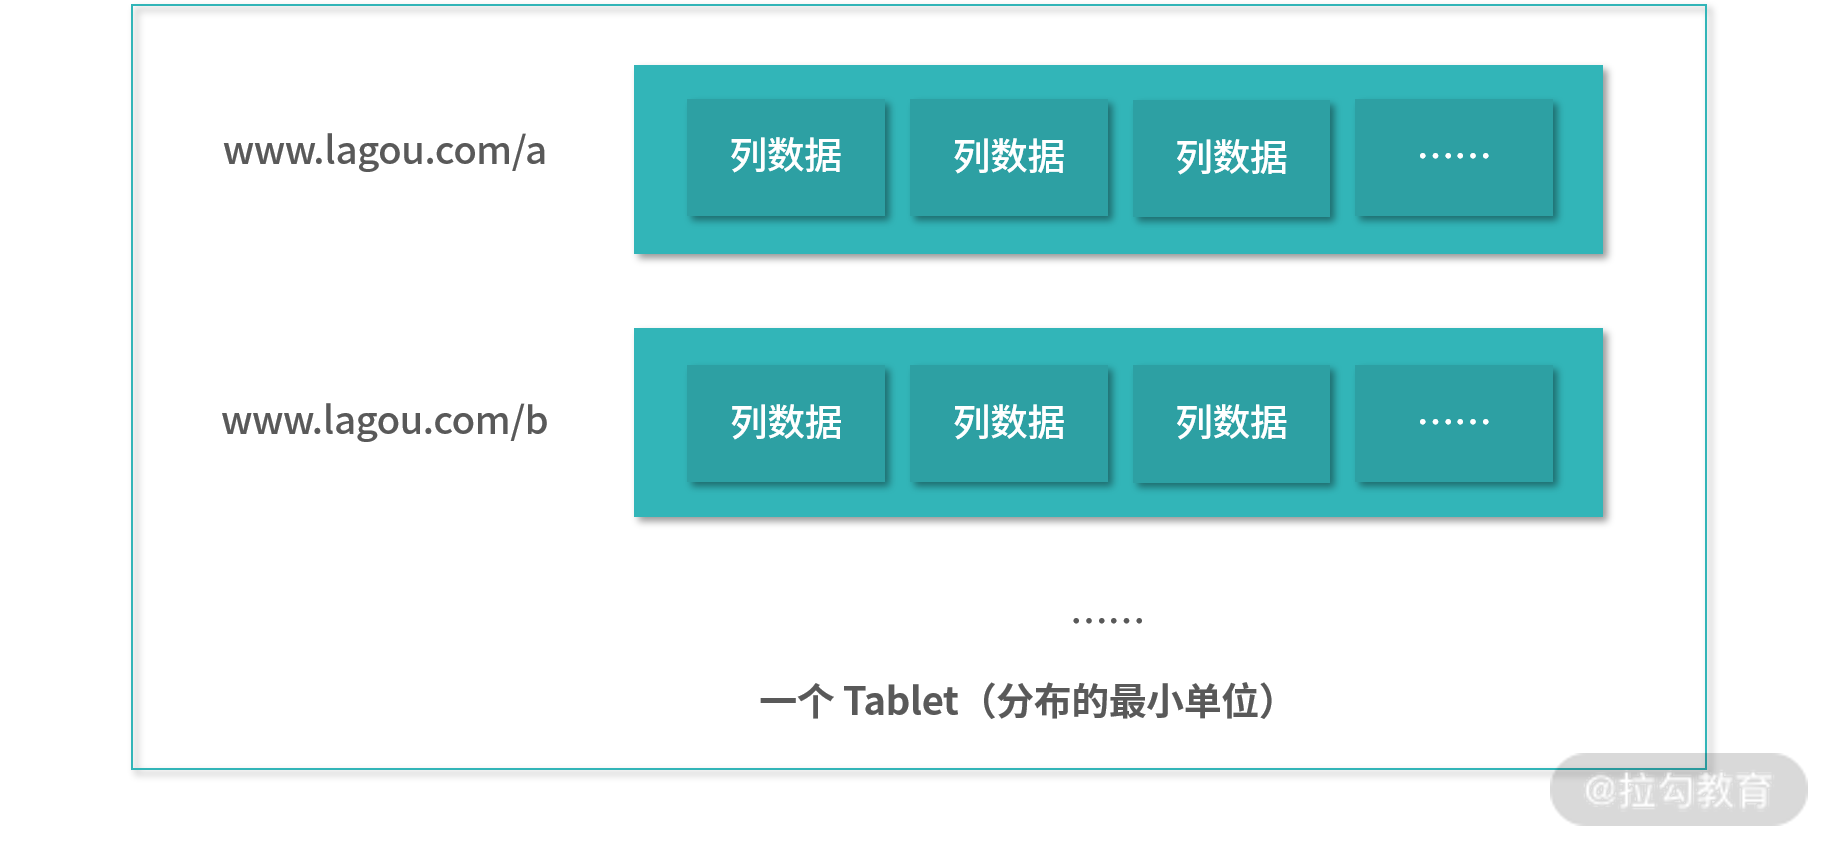
- Chunk:比磁盘 Block 更大的抽象(GFS 64MB、HDFS 128MB),减少 I/O 频率。
架构实体
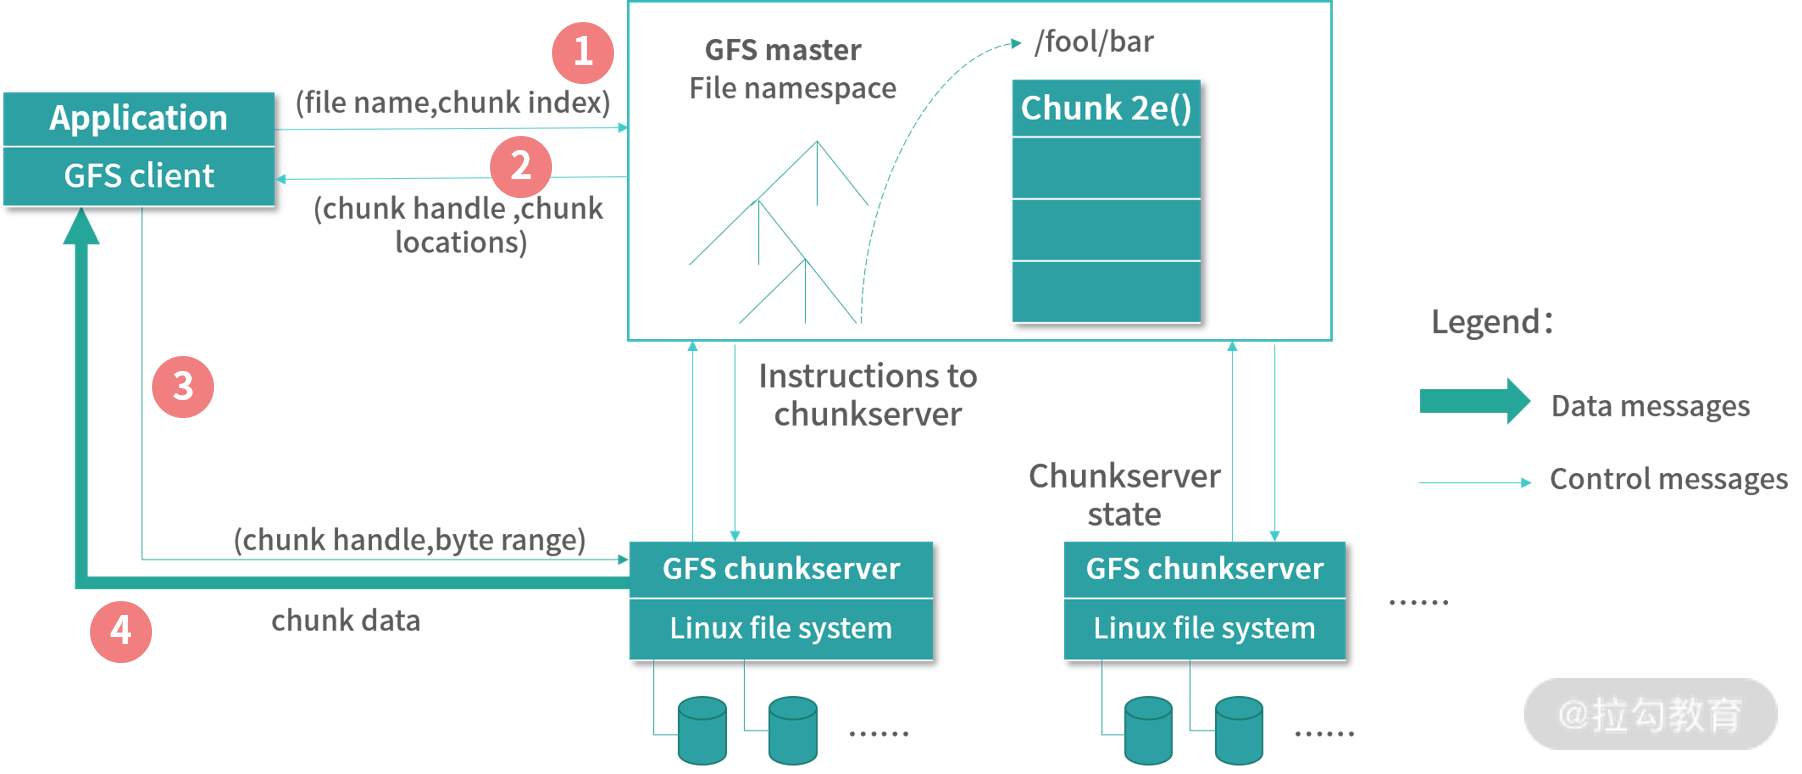
- Client(应用):数据使用方(如 BigTable 是 GFS 的 Client)。
- Master(HDFS 称 NameNode):集中存文件/Chunk 元数据、权限、命名空间,常驻内存并建 B 树索引。
- ChunkServer(HDFS 称 DataNode):存实际 Chunk 数据,频繁向 Master 汇报变更。
读取某文件某 Chunk 某区间需两次往返:客户端 → Master(取 Chunk 地址与句柄)→ ChunkServer(取数据)。
写入模型(GFS)
- 客户端向 Master 申请租约(Lease),获得该 Chunk 及副本的修改权;
- Master 返回所有副本节点位置(含 1 个 Primary + 若干 Secondary);
- 客户端将数据推送给所有 ChunkServer 并缓存(暂不更新);
- 客户端通知 Primary 写入,Primary 再通知 Secondary;
- 各节点返回结果,Primary 回复客户端成功。
先集中推送再统一更新,缩短不一致窗口。GFS/HDFS 牺牲强一致性(允许短时不一致)以换吞吐量。
容灾
HDFS 中 Secondary Node 类似客户端,定期将 NameNode 的变更日志与镜像合并,形成还原点(checkpoint);NameNode 故障时可据此恢复。
小结
- 单机文件系统由 FAT → inode → 日志文件系统演进,日志 + 还原点兼顾性能与容灾。
- B+ 树以冗余非叶节点换取更矮的树、更快的增删与范围查询,是数据库索引主流结构。
- 分布式文件系统以 Master/ChunkServer 分层、Tablet/Chunk 抽象、租约写入实现 PB 级存储与高吞吐。