内存管理
本文整理操作系统的内存虚拟化(虚拟内存、页表、MMU、TLB、大页)、缓存置换算法,以及垃圾回收(GC)的核心原理。
一、为什么需要内存虚拟化
内存资源始终稀缺,进程对内存的需求不断增长,且进程间需要内存隔离。历史上出现过 Swap 技术(不执行的进程整体换出到磁盘),但存在碎片和频繁切换问题。最终沉淀出虚拟内存方案:
- 隔离:每个进程拥有独立地址空间;
- 性能:高频数据留内存、低频数据落磁盘;
- 降低心智负担:程序员无需关心底层物理内存。
虚拟内存为进程提供理论上极大的地址空间。64 位 CPU 可寻址 (2^{64}) 个地址,实际操作系统允许进程使用的地址空间远小于该上限,通常为几十到几百 TB 量级(如 x86-64 Linux 常规为 128 TiB,启用 5 级页表后可达 128 PiB)。
二、页、页表与 MMU
操作系统将虚拟内存分块,每块称为一个页(Page);物理内存同样分块,称为 Frame。Page 到 Frame 的映射由**页表(Page Table)**维护。
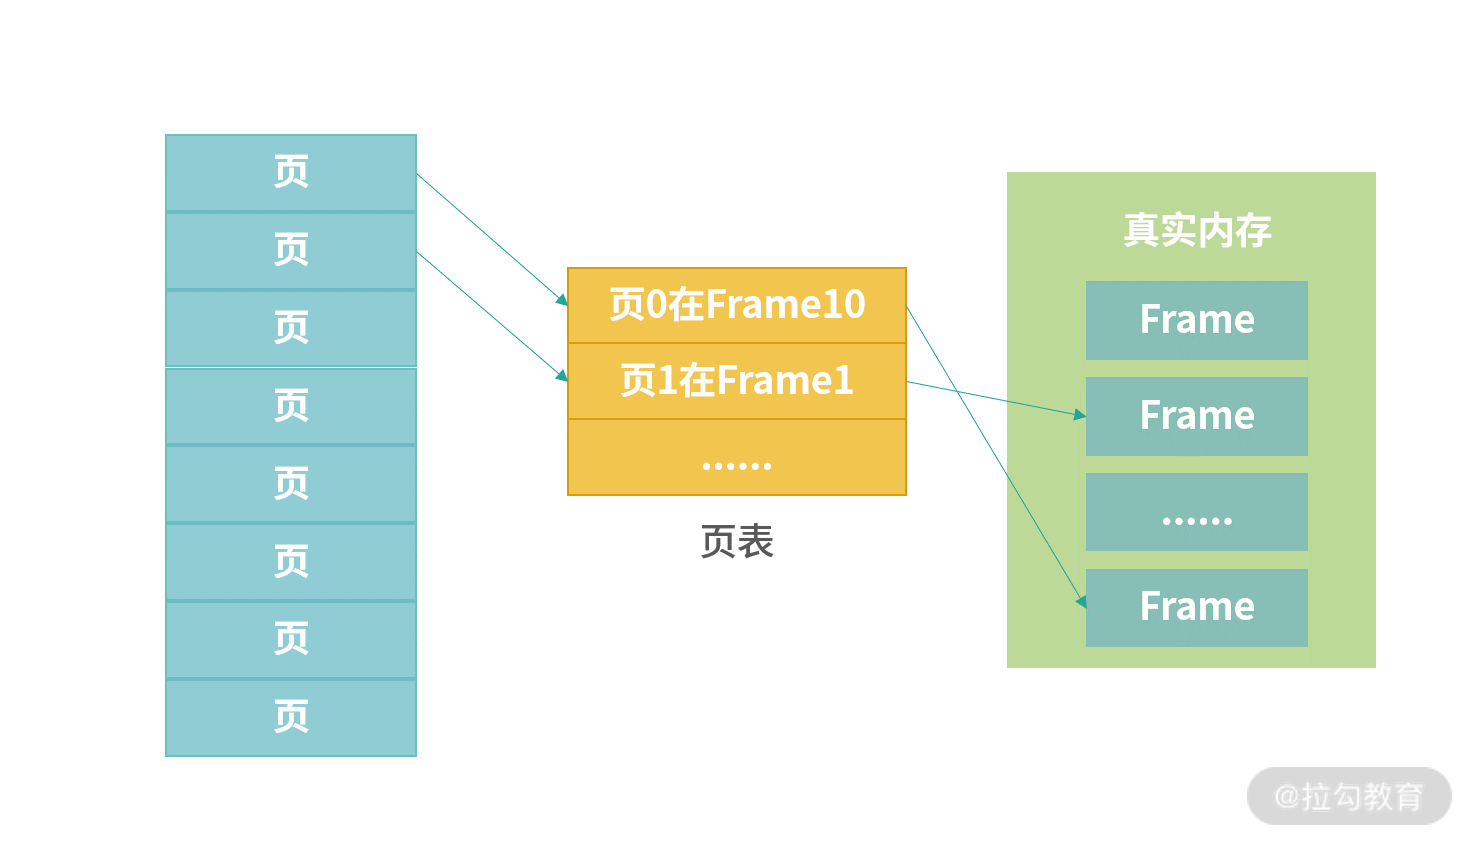
虚拟地址到物理地址换算分 3 步:
- 由虚拟地址计算 Page 编号;
- 查页表,得到 Frame 编号;
- 用 Frame 编号与页内偏移量组装物理地址。
例:页大小 4K,访问地址 100,000:
- Page Number = 100000 / 4096 = 24,偏移 = 1696;
- 查页表得 Frame = 10;
- 物理地址 = 4096 × 10 + 1696 = 42656。
换算在 CPU 内的**内存管理单元(MMU)**中完成。CPU 发出虚拟地址,MMU 查页表算出物理地址并经地址总线访问内存。
(配图缺失:MMU 位置)
页表条目字段
- Absent(在)位:0 表示页在磁盘,1 表示在内存;读 0 触发缺页中断。
- Protection(保护):读/写/执行权限(3 bit)。
- Reference(访问)位:页被读写过,对回收有帮助。
- Dirty(脏)位:页被修改过,回收时必须写回磁盘。
- Caching(缓存)位:页是否可被 CPU 缓存(内存一致性场景置 0)。
- Frame Number:真实内存位置。
多级页表
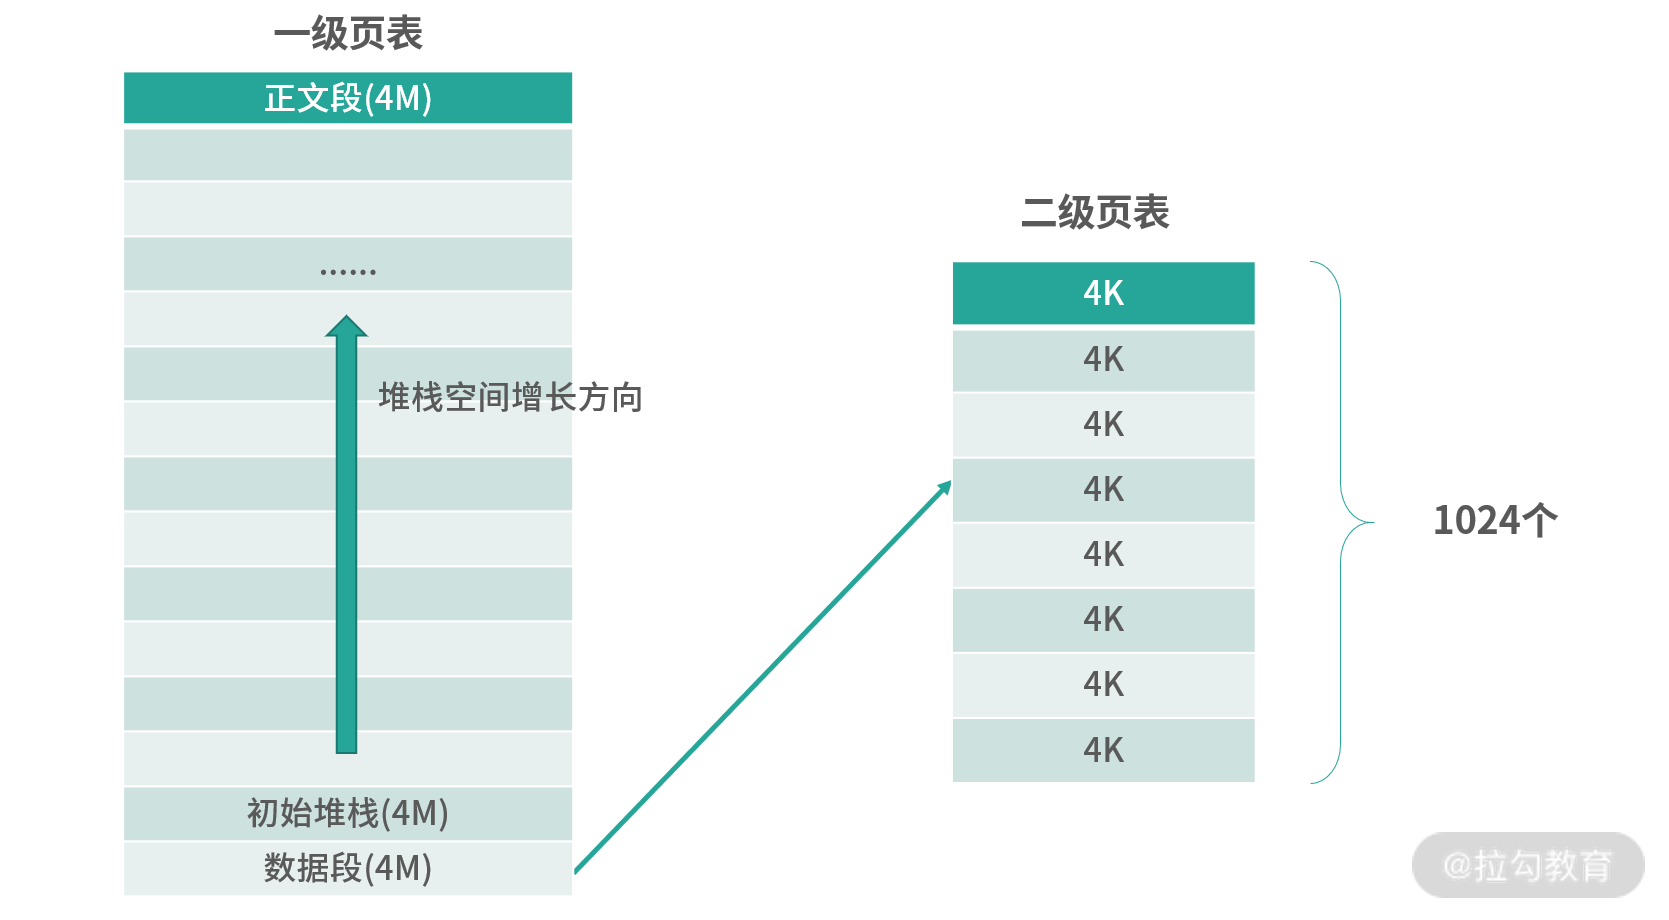
大地址空间若用一级页表,条目数巨大(如 1G 空间需 256K 条目)。采用二级页表:进程内部用大页(如 4M)管理,OS 仍用 4K 页。MMU 先查一级再查二级,顶级页表只需创建已用部分,大幅降低进程创建成本。可递归扩展至 3、4 级。
三、TLB 与大内存页
MMU 查页表需访问内存,速度慢。为此 MMU 内集成转置检测缓冲区(TLB,快表),缓存 Page Number → Frame Number 映射。局部程序反复访问相同地址,几十个 TLB 条目即可获得高命中率;多核 CPU 每核心有独立 TLB(如 i7:L1 TLB 64 条、L2 TLB 1024 条)。
TLB Miss
- 软失效(Soft Miss):Frame 在内存,仅 TLB 无缓存,刷新 TLB 即可。
- 硬失效(Hard Miss):Frame 不在内存,触发缺页中断,从磁盘加载后更新 TLB 并唤醒线程,耗时明显。
TLB 缓存映射方案
- 全相联映射:任意条目可存任意数据,硬件可并行查,但条目多时速度下降。
- 直接映射:类似哈希
缓存行号 = PageNumber % N,不支持 LRU 类置换,命中率受限。 - n 路组相联映射:每个 Page Number 可出现在 n 个固定位置,支持 LRU 置换(如 4-way 64 条 / 8-way 1024 条)。
大内存页(Huge Page)
应用内存需求大(如 1G)而默认 4K 页时,页数达 26 万,TLB 易冲突。Linux 2.6+ 提供 Huge Page,可显著减少页数、提升 TLB 命中。开启:
bash
sudo sysctl -w vm.nr_hugepages=2048Java 可用 -XX:+UseLargePages 启用。适合内存需求大或高并发抗流量的场景。
四、缓存置换算法
缓存命中(Hit)/穿透(Miss)。平均响应 ≈ M·T + L(M 穿透率、T 穿透代价、L 缓存延迟)。目标是将未来最低频使用的数据置换出去。
悲观策略
- 随机:公平但易置换掉热点。
- FIFO:队列(链表)实现,按到达时间淘汰,忽略使用频率。
- FILO:栈实现,同样与实际频率无关。
NRU(最近未使用)
利用页表访问位/脏位,定时清零,优先置换读写位均为 0 的页。简单有效、被广泛使用。
第二次机会算法:FIFO 置换前检查读位,读位为 1 则移到队尾并清 0(多给一次机会)。可用循环链表实现,省去节点从队首搬到队尾的开销。
LRU(最近最少使用)
置换最久未使用的数据。常见实现:双向链表(使用则移到表头,置换从表尾删除)+ 哈希表查询(如 Java LinkedHashMap)。缺点是高并发场景维护链表+哈希开销大。
描述"最近":用页表读位累加计数得到使用频次(LFU),但 LFU 不会遗忘旧热点。改进为 Aging(老化)算法:用 8 位计数器 A,每 Tick 将 A 右移一位,把读位 R 置于最高位。有访问 A 升、无访问 A 降,无访问则归 0,从而用数学描述"最近"。硬件实现 Aging 可高效模拟 LRU。
五、垃圾回收(GC)
GC 的定位与指标
GC 不仅是回收模块,往往是应用实际的内存管理者,负责向 OS 申请/释放内存、向应用分配内存、标记回收垃圾、按应用特性动态优化。核心指标存在权衡(不可兼得):
- 吞吐量(Throughput):非 GC 时间占比;
- 足迹(Footprint):应用对内存的占用;
- 暂停时间(Pause Time):Stop The World(STW)时长。
并发度越高,拆分/同步/空间开销越大;暂停时间越短,GC 与应用交替越频繁。
引用计数(Reference Counting)
每个对象维护引用计数,归 0 即回收。问题:
- 循环引用:互相引用的对象计数恒为 1,永不回收;
- 容错差:竞争条件算错一次即永久泄漏;
- 产生碎片。
Root Tracing
从根对象(Root,如栈上指针、全局对象)出发遍历引用链,不可达对象即垃圾,可正确处理循环引用,且容错性好(下次扫描可纠正)。标记-清除与三色标记均属于此类。
标记-清除(Mark Sweep)
白=待回收,黑=保留。所有对象初始染白;从 rootSet 对每个 Root 递归 DFS 标记其引用对象为黑;最后遍历 heapSet 回收仍为白色的对象。缺陷:用户程序删除黑色对象引用后产生浮动垃圾,需下次 GC 处理。
三色标记-清除(Tri-Color Mark Sweep)
- 白:待回收;黑:确定保留;灰:未完成标记(增量任务)。
- 初始全白;Root 直接引用对象入灰;循环从灰色集合取元素标记,遍历其引用,全部引用处理完则转黑。
- 支持 Mark/Mutation/Sweep 交替执行,新增对象标灰、调整引用时把受影响对象重新标灰,提高并发回收概率。
- 并发需保证白/黑/灰三集合线程安全(ConcurrentSet 或临界区加锁)。
碎片整理与生代技术
标记-清除产生碎片,需 Compact 将存活对象挤压到连续空间。观察:新对象死亡概率高、老对象更持久。据此划分区域(以 Java 为例):
- Eden(伊甸园):新对象,频繁 GC,存活者拷贝到 Survivor;
- Survivor(存活区):存活对象,再进入老生代;
- 老生代:存活周期长,GC 频率低。
三区域死亡概率递减、存活周期递增,均用三色标记-清除。
GC 选型
- 内存需求小、GC 压力小:双色标记-清除,简单省时;
- 暂停时间不敏感(如数据分析):并发双色标记-清除;
- 内存大且要求短暂停:三色标记-清除(支持增量并发);
- 高并发频繁迭代:生代算法;
- 实时性极高:专用引擎(如 Java ZGC)。
内存不足时,可降低吞吐量(GC 时间上升)或增加暂停时间。多数语言提供吞吐/暂停阈值参数;内存充裕时建议提高阈值、延后 GC 以提升整体效率。
小结
- 虚拟内存通过页表+MMU 映射,TLB 加速地址换算,大页缓解 TLB 冲突。
- 缓存置换从 FIFO/随机演进到 NRU、LRU(可用 Aging 模拟)。
- GC 以 Root Tracing + 三色标记解决循环引用与并发回收,生代技术降低碎片与停顿。