分析服务的特性与进程线程数量规划
服务上线前需评估容器数、CPU 数、进程/线程数,并依据服务特性、目标并发、吞吐、可承受延迟调整。资源给多则闲置浪费,给少则无法工作甚至雪崩。
计算密集型与 I/O 密集型
- 计算密集型:主要开销在 CPU 算术运算(如深度神经网络、高并发下订单价格计算)。
- I/O 密集型:主要开销在设备读写(键盘、磁盘、网络、日志、数据库)。I/O 期间 CPU 转去执行其他任务,完成时设备发中断通知 CPU。
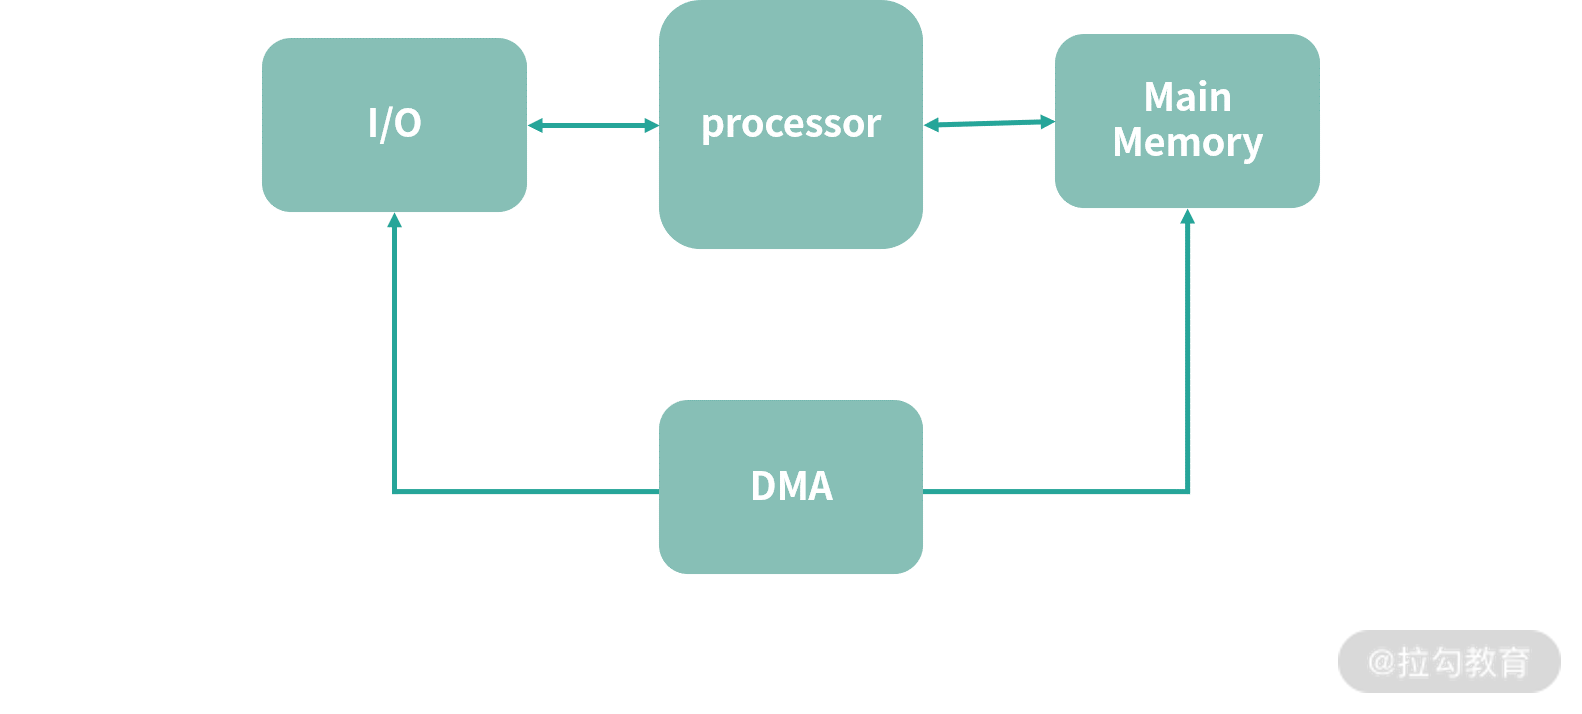
I/O 数据搬运通常不消耗 CPU——DMA(Direct Memory Access)模块允许硬件直接写内存。但若用 memcpy 逐字节拷贝数组,则属 CPU 密集。区分类型需结合实际指标,例如用好固态阵列后,数据库查询瓶颈可能转移到缓存搜索(计算)。
CPU 工作指标
CPU 有忙碌、空闲两种状态,虚拟机还可能被宿主"偷走"时间。
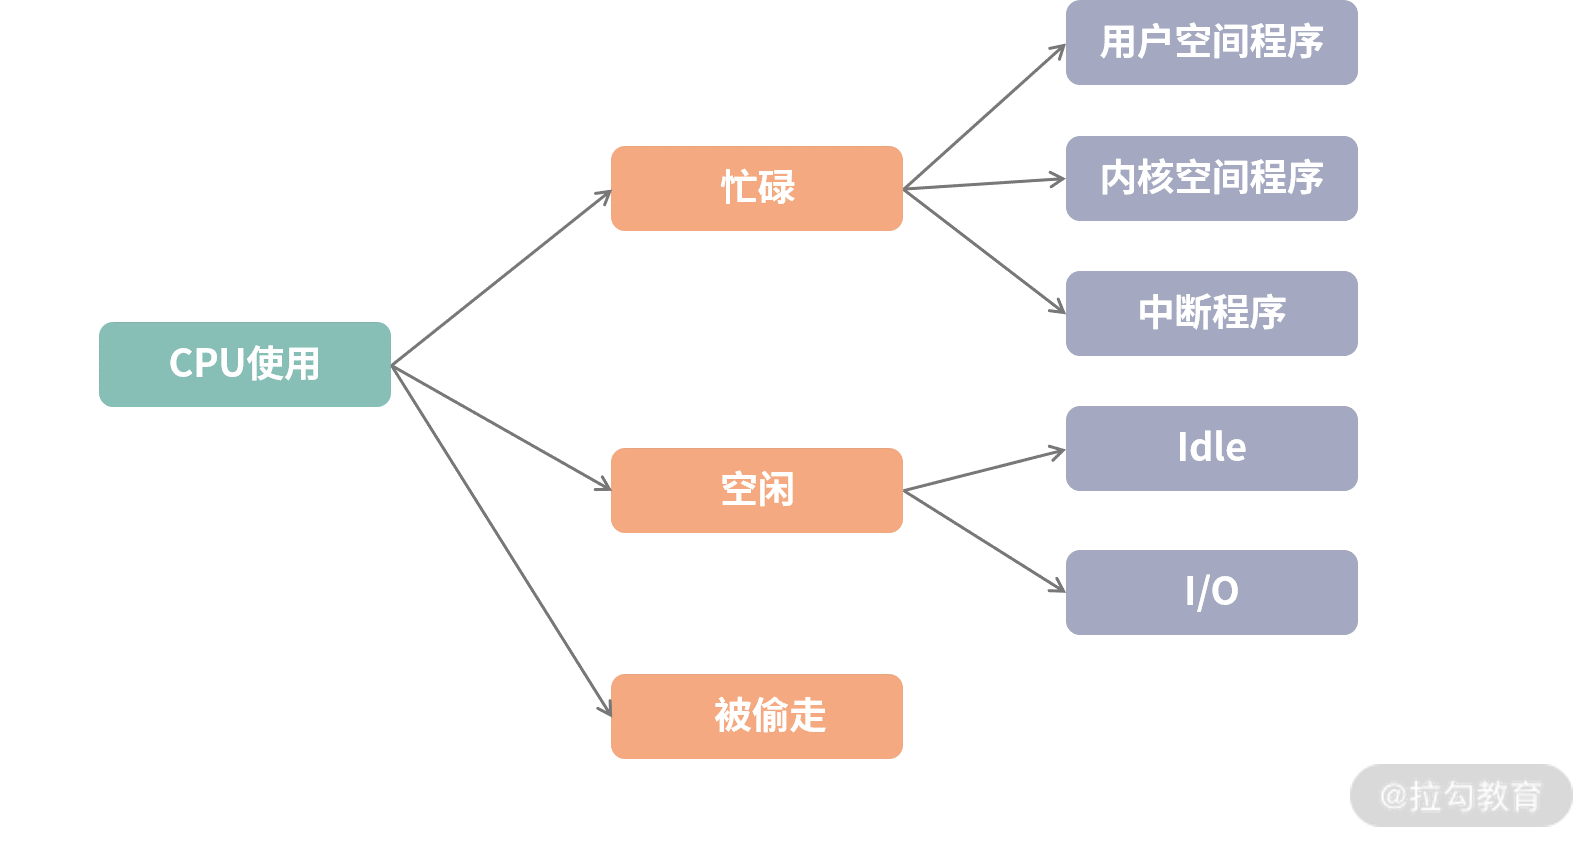
- 忙碌:执行用户空间程序、内核空间程序、中断程序。
- 空闲:执行空闲指令(低能耗空转);或等待 I/O 的 I/O Wait。
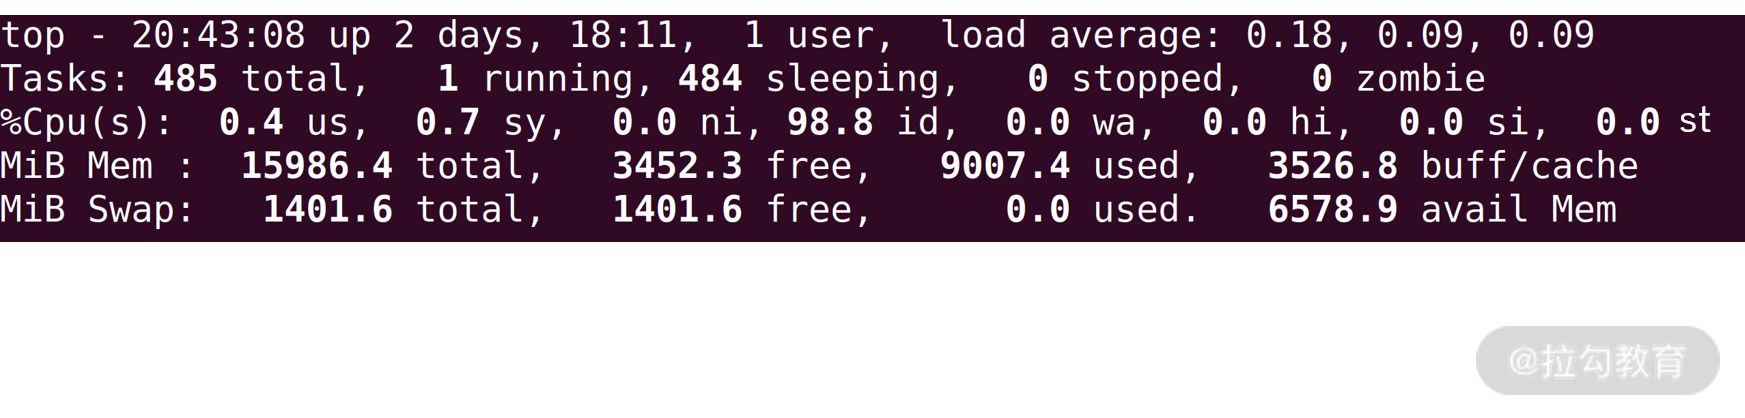
top 指令第 3 行给出 CPU 占比:
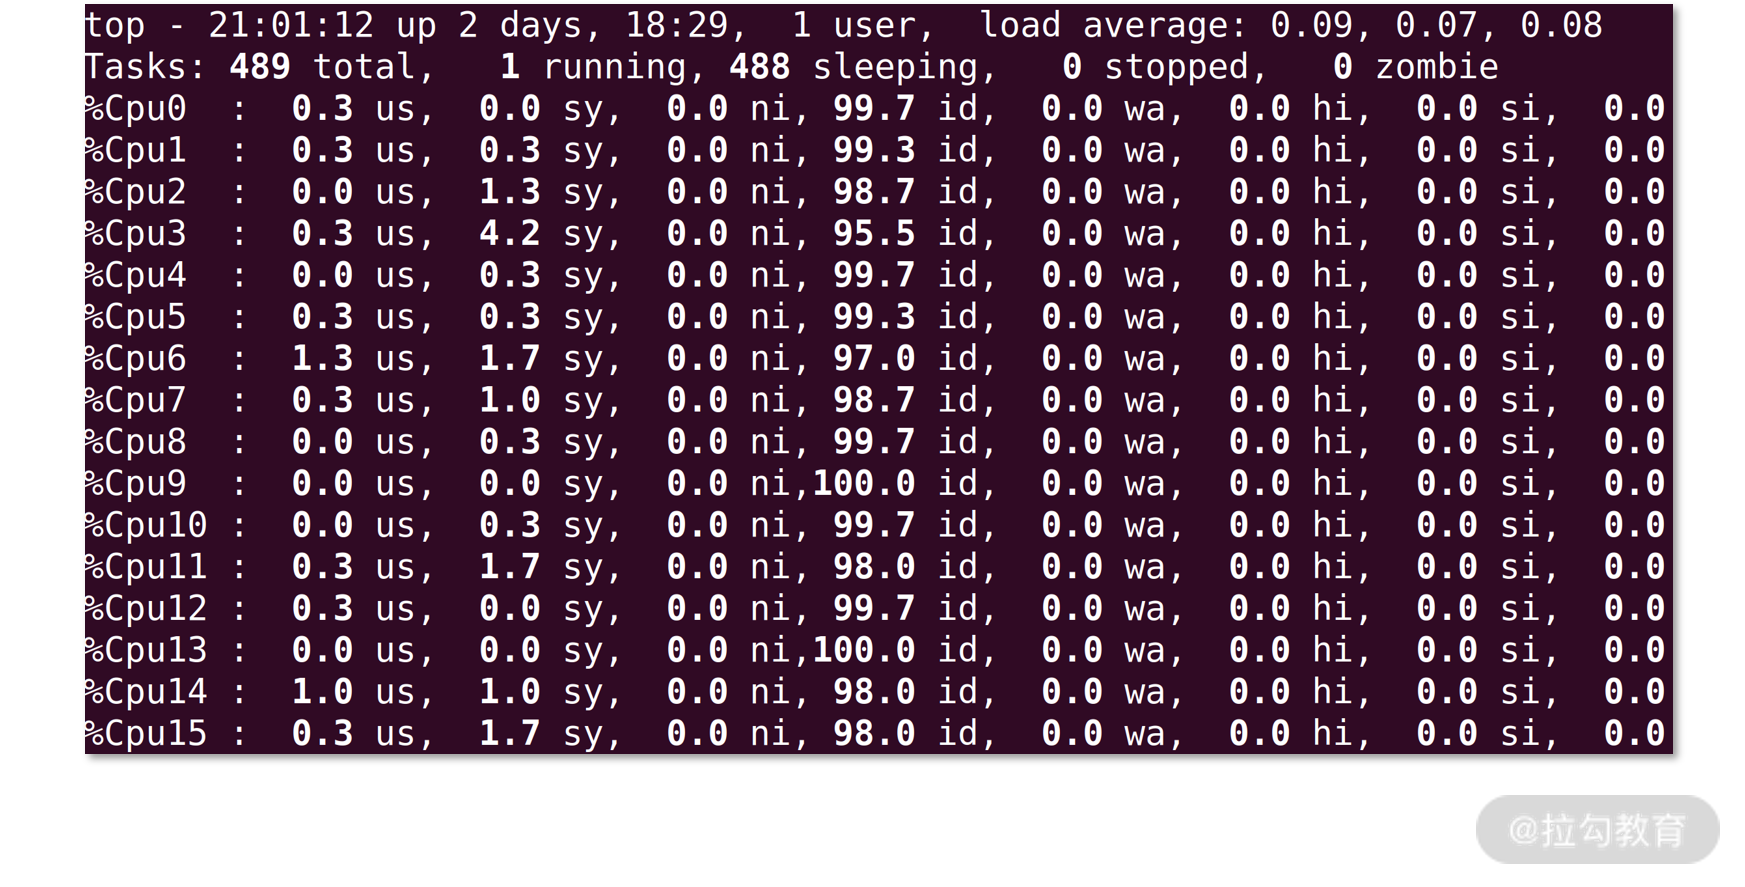
us用户空间;sy内核空间;ni调整过优先级的进程;id闲置;waI/O Wait 闲置;hi/si硬/软中断;st虚拟机被宿主偷走的时间。top后按1可看各核明细。
负载指标(Load Average)
load average 表示一段时间内处于可运行(含排队)及不可中断 I/O 等待状态的平均任务数(top 显示的原始值未按核数折算);与 CPU 核数比较,大于 1 说明 CPU 相当忙碌。若负载高且 I/O Wait 高,说明 CPU 大量等待 I/O(频繁打日志、读写数据库/网络),可优化为批量读写(一次写 1M 比写百万次 1 字节快,能复用缓存与连接)。详见 /proc/loadavg。
通信量(Traffic)
网络瓶颈可查 /proc/net/dev:
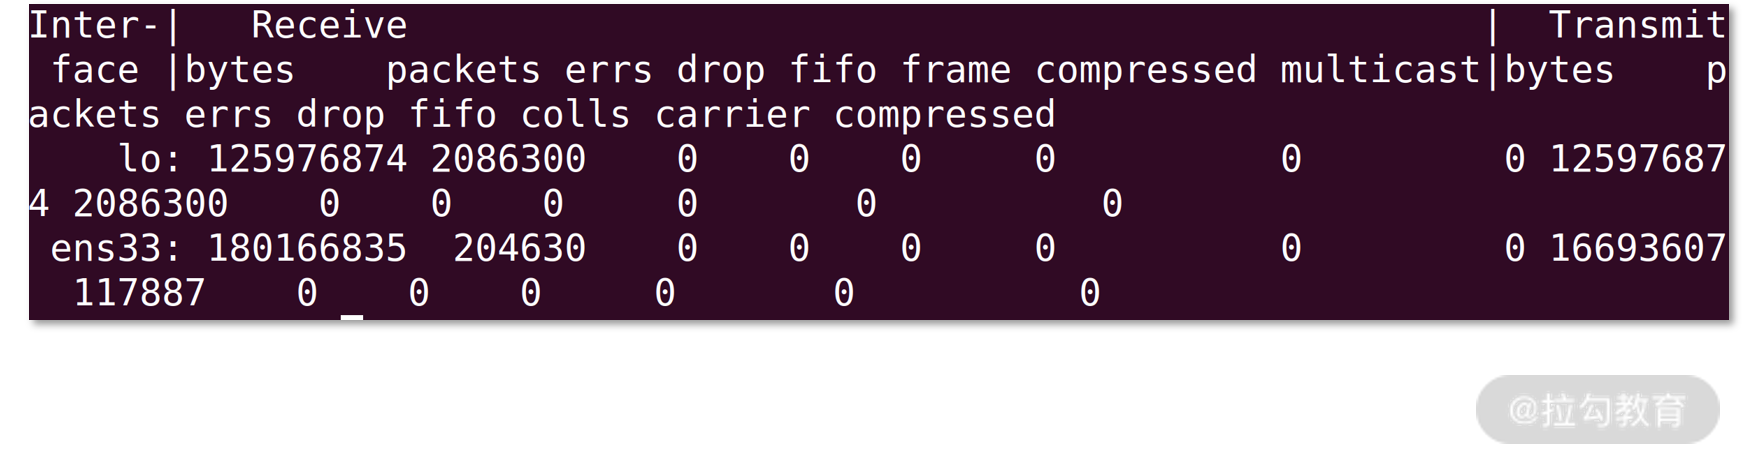
- 表头分 Interface(网卡)、Receive、Transmit;
- 指标含 byte(字节)、packets(封包)、errs(错误)、drop(丢包)、fifo(FIFO 缓冲错误)、frame(帧错误)。
磁盘指标
I/O 频繁导致磁盘瓶颈时,可用 iotop 看实时读写速度与进程排行:
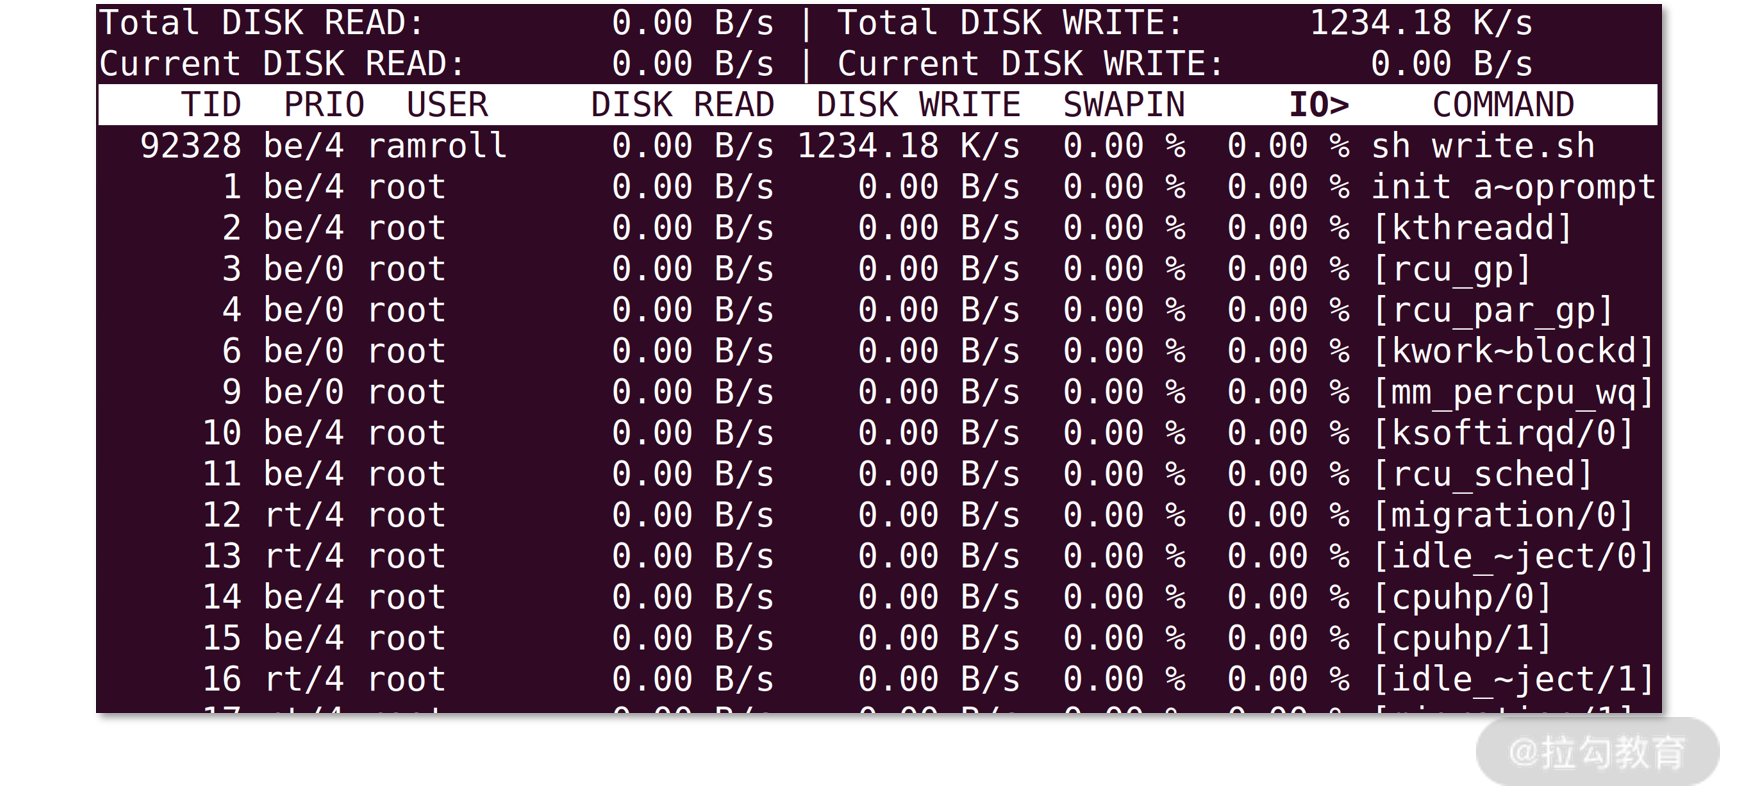
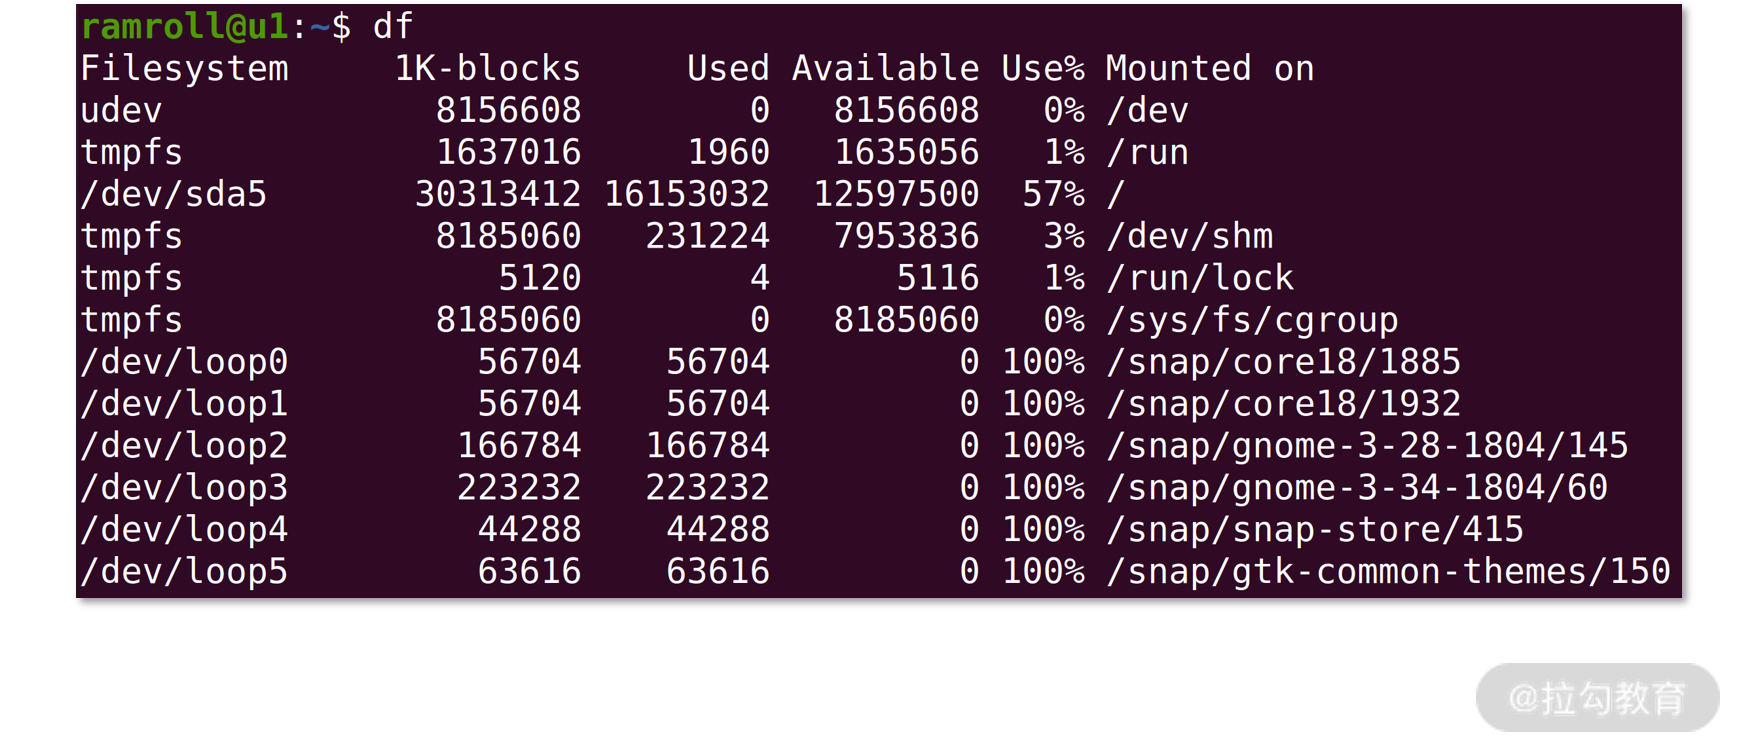
空间不足用 df(按挂载的文件系统计算)。细粒度 I/O 看 /proc/diskstats。
监控平台
Linux 指令可查 CPU/I/O/网络等维度。自建复杂,可用开源工具(如 Taobao System Activity Report / tsar)定时收集,配合 logstash、ELK 做监控分析。
决定进程/线程数量
线程/进程数 = CPU 核数 并非最优。各语言模型不同:
- Node.js:事件循环(协程式),大量协程复用进程,效率高于线程池;
- PHP:多进程模型较弱;
- Java:多线程,线程与内核线程 1:1;
- Go:轻量级线程(goroutine),多个复用内核线程。
考虑 I/O Wait 的存在:若应用仅用 50% CPU 时间、另 50% 等待 I/O,则 1 个 CPU 可同时承载 2 个线程。一般模型下,单线程 I/O 占比为 P,n 个线程都在等待 I/O 的概率为 (P^n),CPU 利用率 = (1 - P^n)。理论上 P=50% 时 4 个线程 CPU 利用率已达 93.75%,但实际调度为分时行为,会有闲置。
因此实际线程/进程数通常超过核数。建议以"核数 × 3"起步做真实压测,据结果调整:
- 瓶颈在 CPU(
load average高):优化 I/O Wait,或采用延迟读写、减少读写; idle高、CPU 闲置多:增加线程。
小结
- 计算密集型:线程/进程数接近核数,负载高时留 1 核给 OS。
- I/O 密集型:开大于核数的线程/进程。
- 语言特性影响模型:Node.js 可长期用"核数-1"进程;Java 线程池需大于核数。
- 核心原则:上线前必须压测,并持续监控不同并发下的资源表现。